
工具简介
音频转文字是一款注重隐私的语音识别工具:AI 模型直接在浏览器本地运行,MP3、WAV、M4A、FLAC、OGG 等音频文件不会上传到任何服务器,会议录音、采访素材等敏感内容也能放心识别。支持中文普通话、英语和自动检测三种语言模式,识别结果可以导出为纯文本 TXT,也能导出带时间轴的 SRT / VTT 字幕文件,直接用于视频字幕制作。
单个文件最大支持 10MB(约 10 分钟音频),适合会议纪要、课堂录音、播客文稿、字幕初稿等场景。
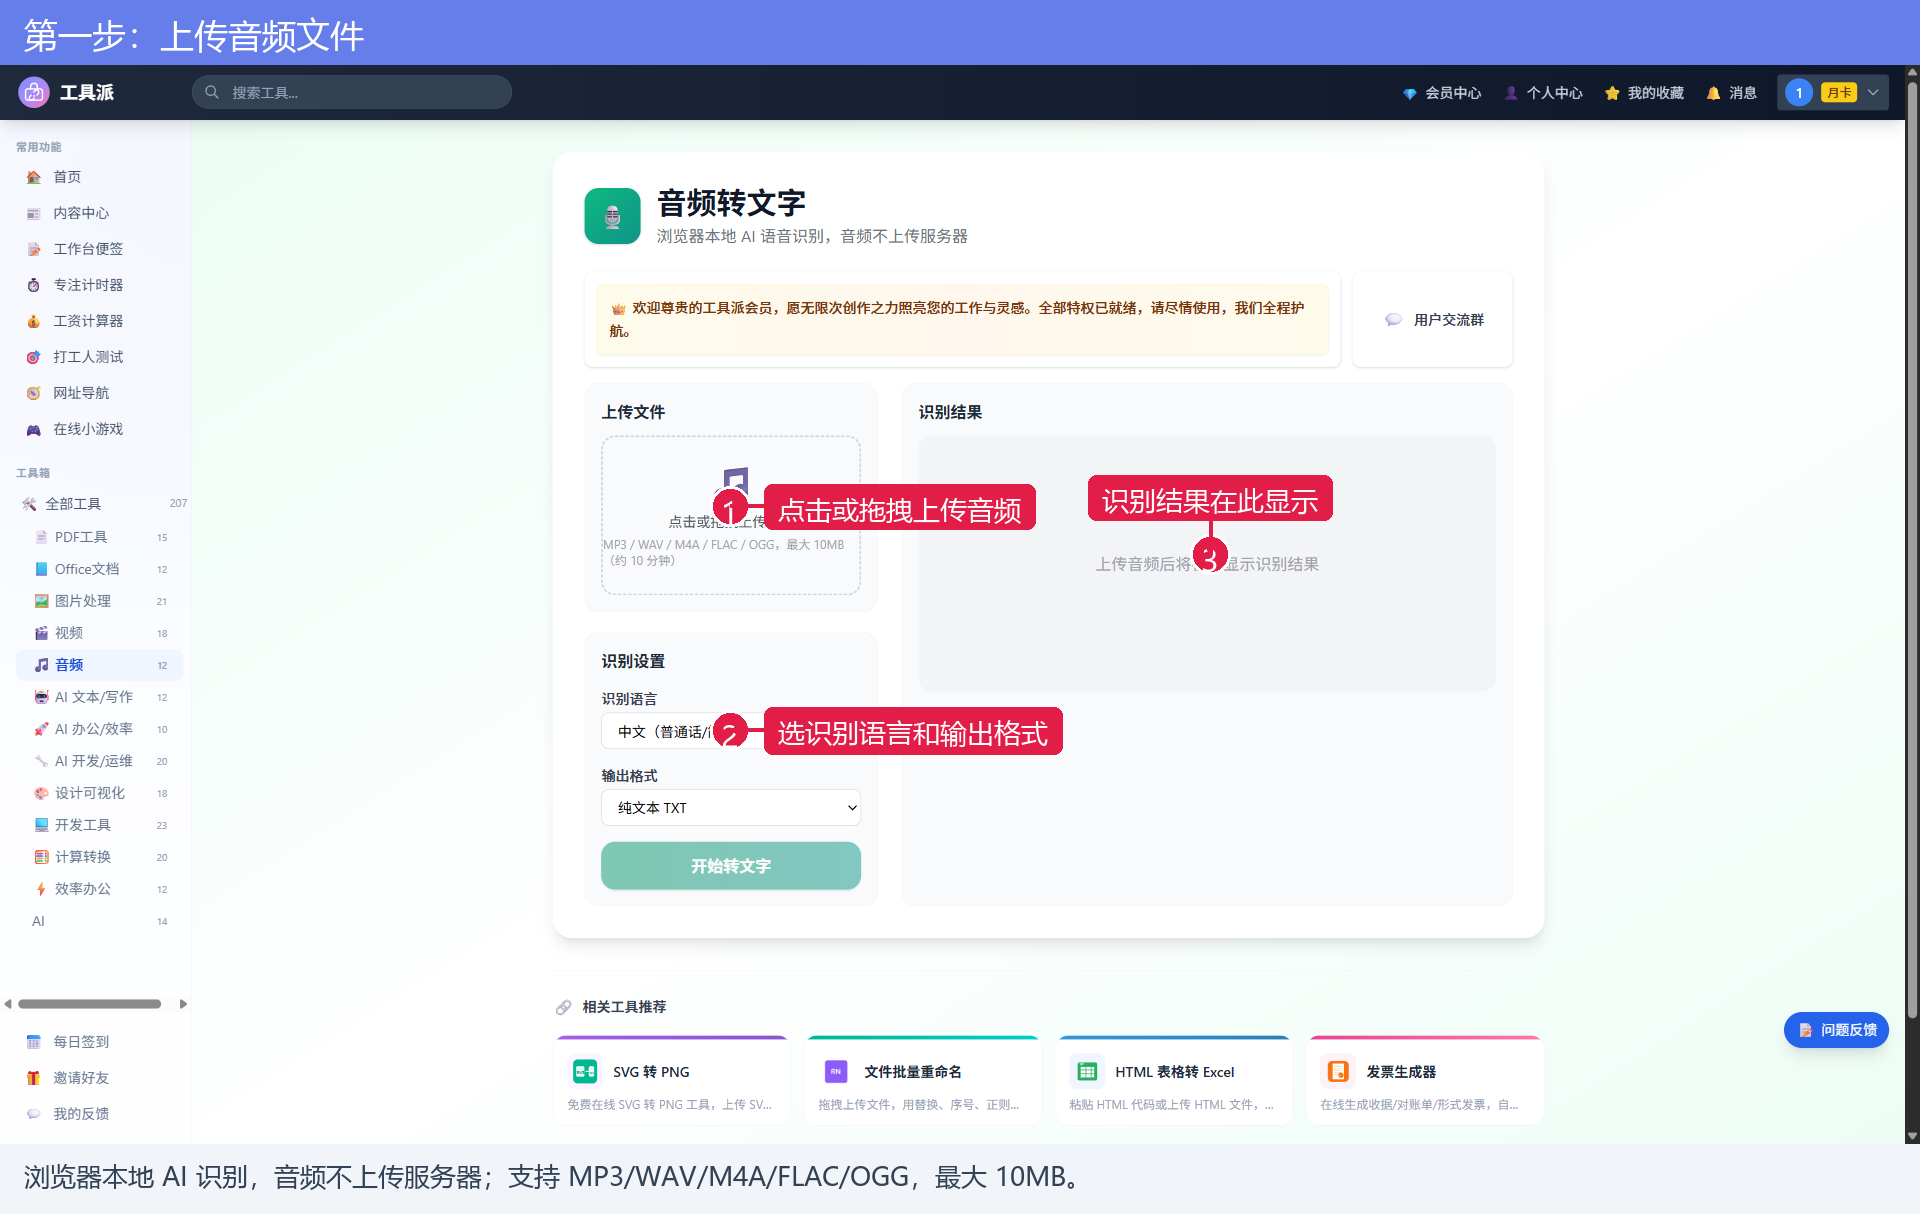
第一步:上传音频文件
点击上传区域选择音频文件,或直接把文件拖拽到网页中。上传后下方会显示已选文件名,「开始转文字」按钮由灰变绿。
支持格式:MP3 / WAV / M4A / FLAC / OGG,最大 10MB(约 10 分钟)。如果音频更长,建议先用音频工具裁剪分段后再识别。
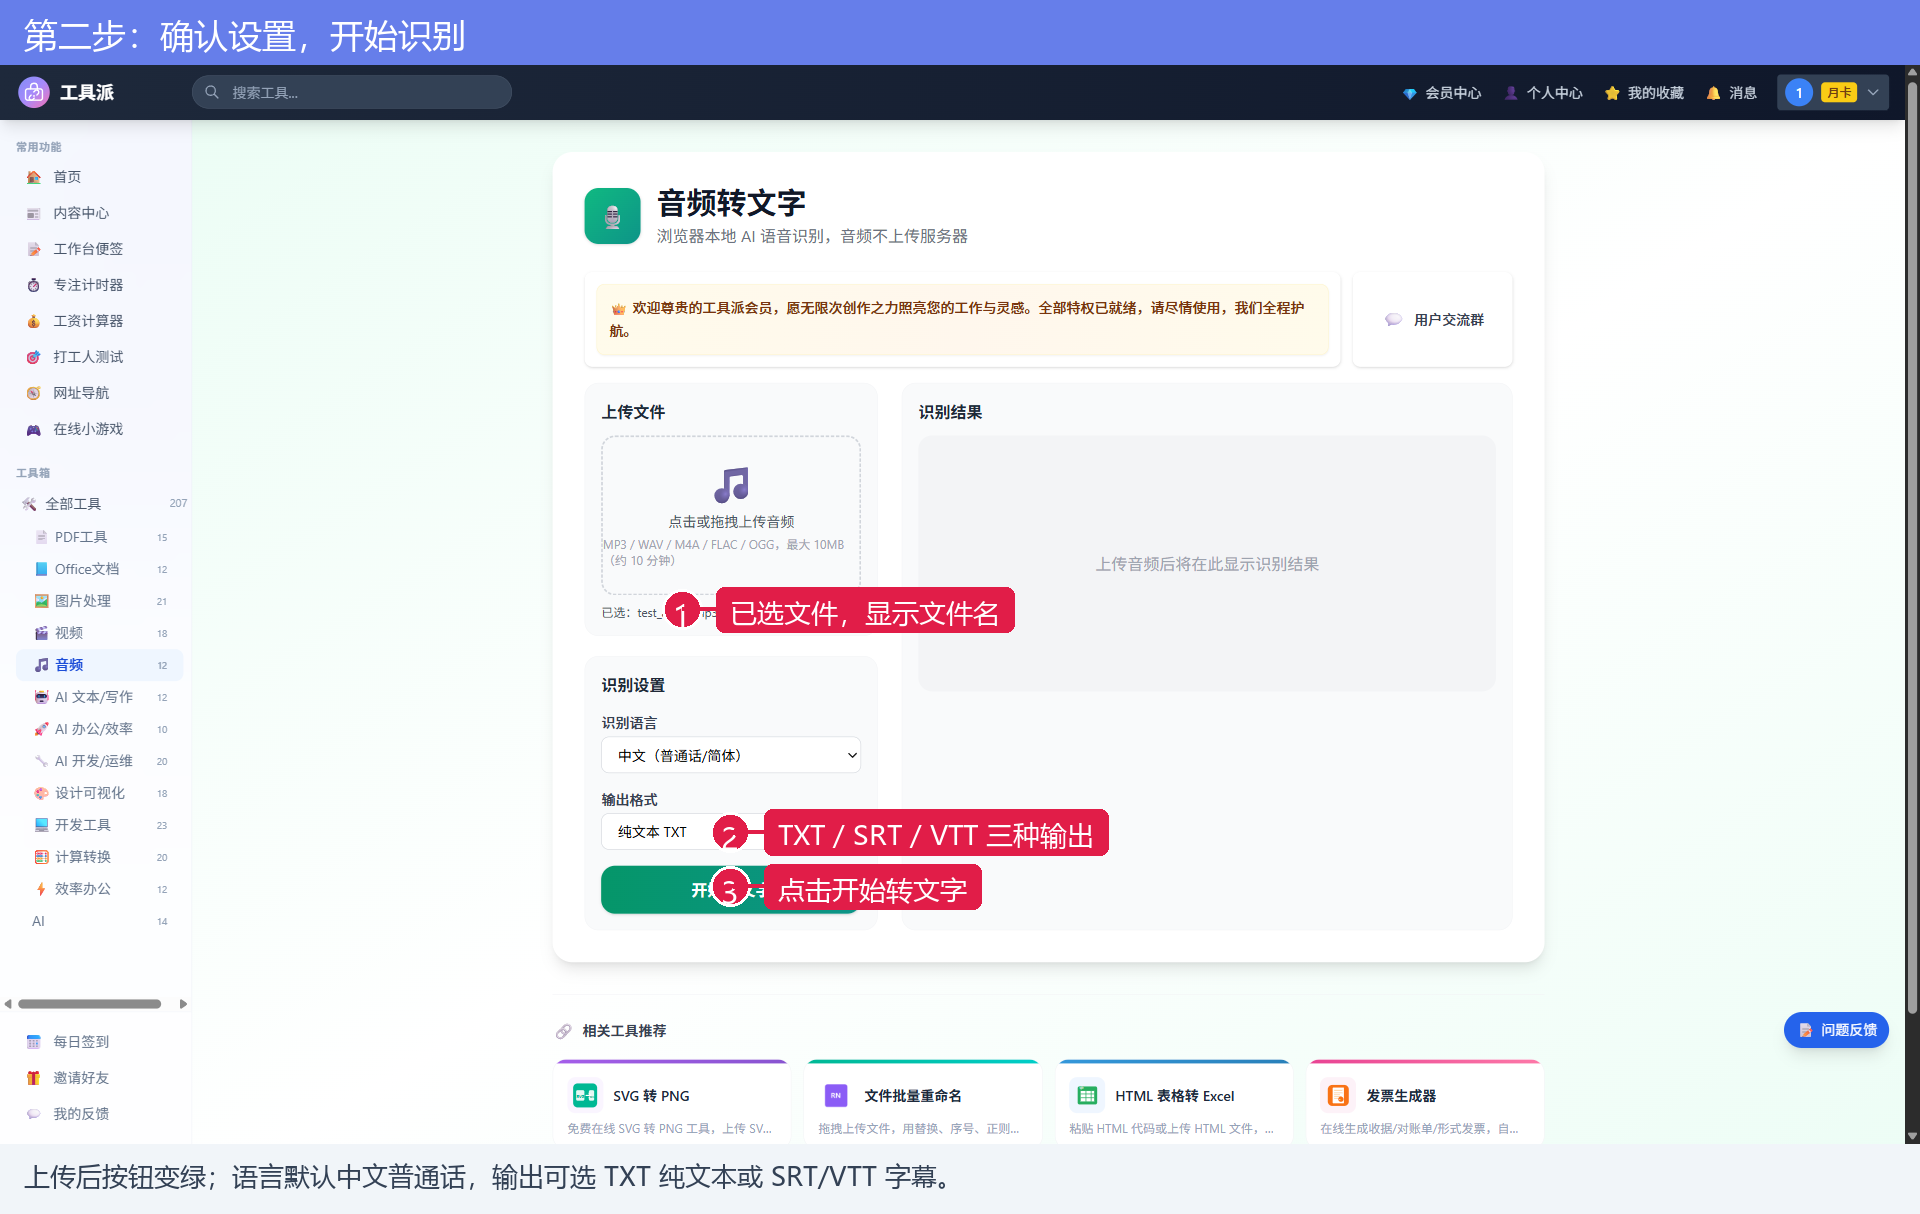
第二步:设置识别参数
- 识别语言:中文(普通话/简体)、英语、自动检测三种可选。中文音频选中文准确率最高,识别结果会自动转为简体;不确定语言时选自动检测;
- 输出格式:
- 纯文本 TXT:只要文字稿,适合会议纪要、文稿整理;
- SRT 字幕:带时间轴, Premiere、剪映等剪辑软件可直接导入;
- VTT 字幕:网页播放器(HTML5 video)标准字幕格式。
参数说明
| 参数 | 类型 | 可选值 | 说明 |
|---|---|---|---|
| 文件上传 | 文件选择 | MP3/WAV/M4A/FLAC/OGG | 最大 10MB,本地处理 |
| 识别语言 | 下拉 | 中文(普通话/简体)/ 英语 / 自动检测 | 中文结果自动转简体 |
| 输出格式 | 下拉 | 纯文本 TXT / SRT 字幕 / VTT 字幕 | 决定下载文件类型 |
| 开始转文字 | 按钮 | — | 上传文件后激活 |
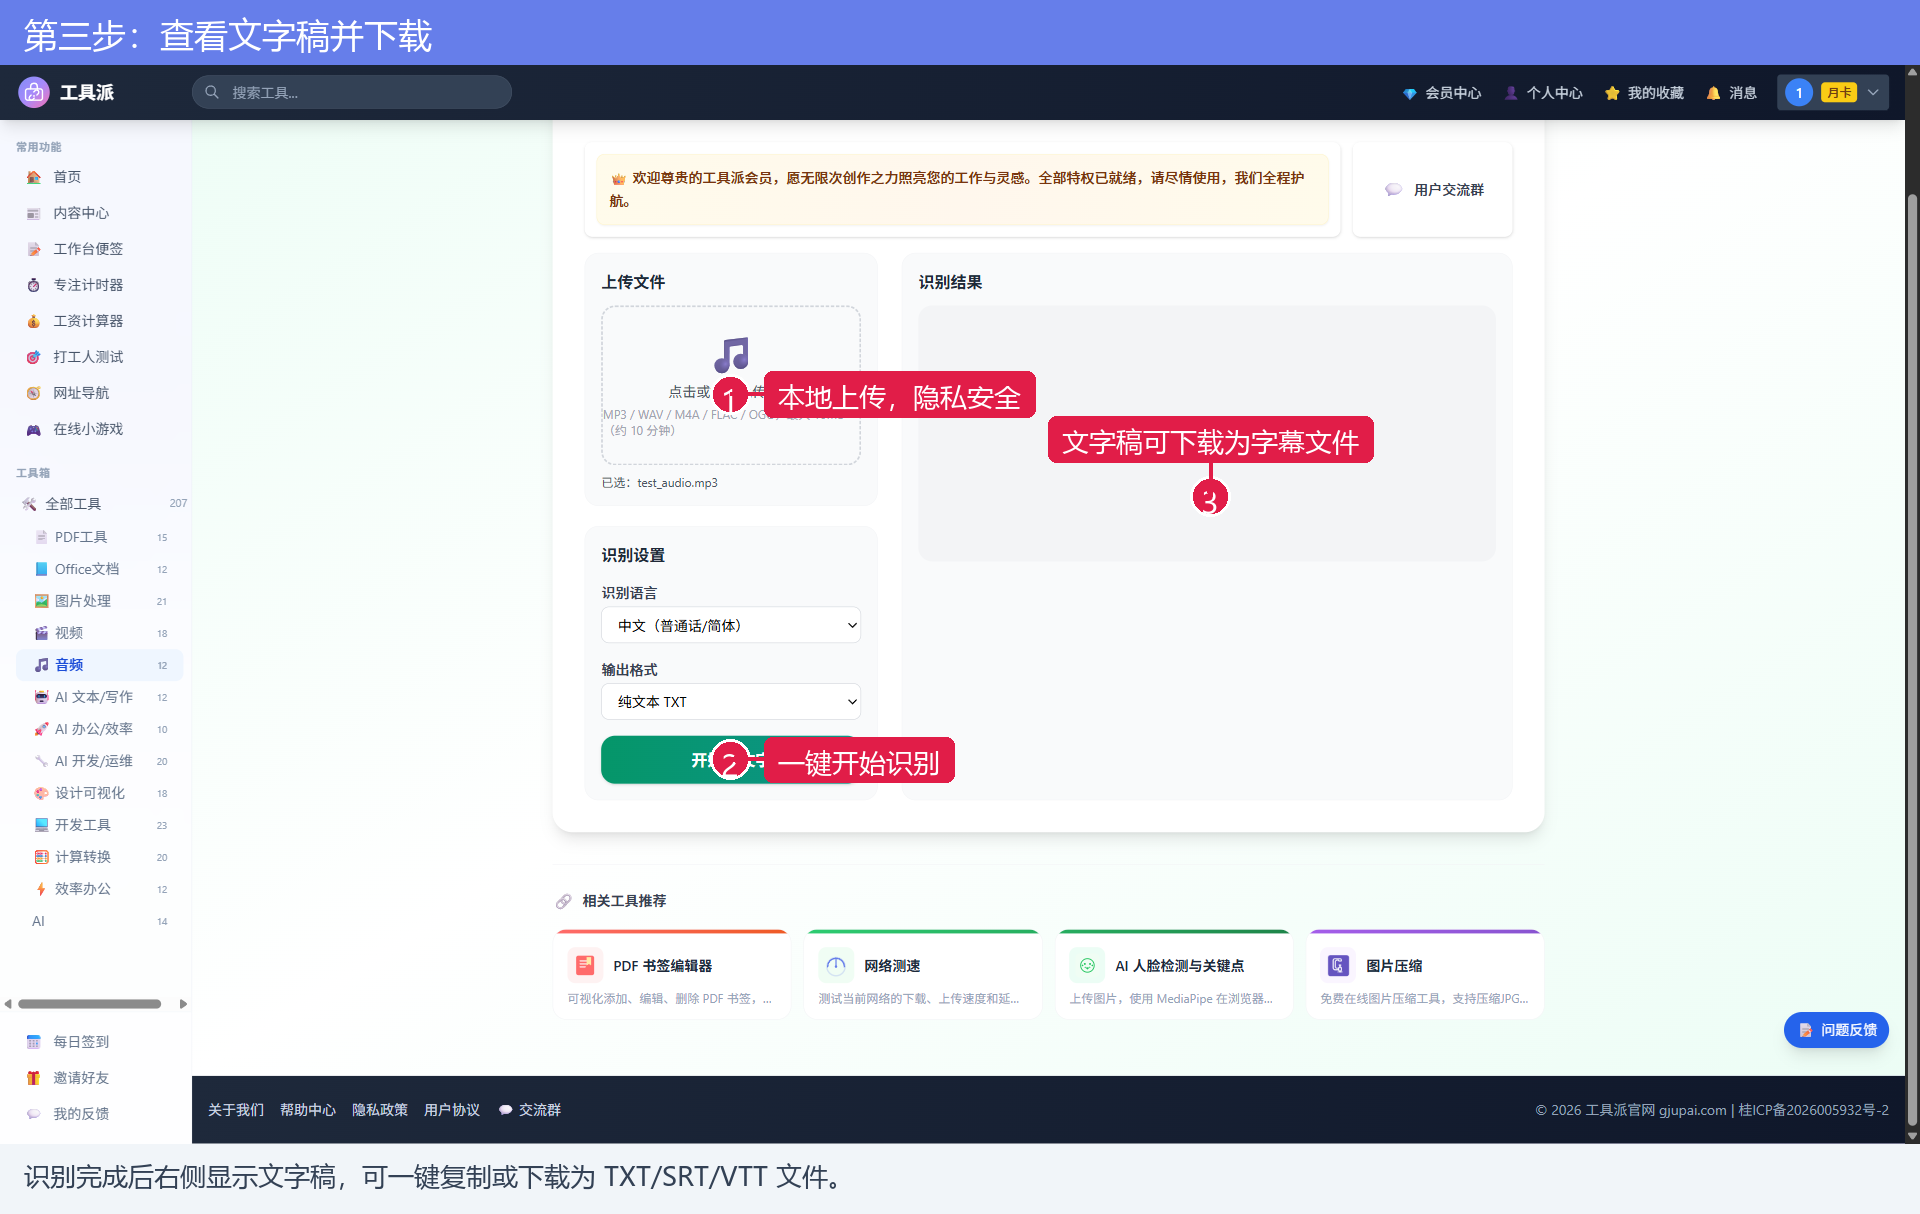
第三步:查看结果并下载
点击「开始转文字」后,页面会显示模型加载和识别进度(首次使用需要加载 AI 模型,稍等片刻)。识别完成后,右侧「识别结果」区域显示完整文字稿,可以一键复制,或按所选格式下载文件。
选择 SRT/VTT 格式时,文字稿会按语句自动切分时间轴,导入剪辑软件即为可用字幕。
常见问题
Q:识别要联网吗?安全吗?
A:首次使用需联网下载 AI 模型到浏览器缓存,之后识别过程全部在本地运行,音频不会上传到服务器。
Q:为什么限制 10MB?
A:识别在浏览器里运行,受内存和算力限制,10MB(约 10 分钟)是稳定运行的经验上限。
Q:识别准确率怎么样?
A:清晰普通话录音准确率较高;背景噪音大、多人抢话或方言较重时准确率会下降,建议先用「音频降噪」处理。
Q:能识别视频里的声音吗?
A:可以先用「视频音频提取」把视频转成 MP3,再来这里转文字。
总结与相关工具
音频转文字三步完成:上传音频 → 选语言和格式 → 识别下载。搭配以下工具可以覆盖更多语音处理场景: