
工具简介
AI 人声分离是工具派推出的免费在线音轨分离工具,基于本地 Spleeter ONNX 模型,可以把一首歌曲拆分成独立的人声轨和伴奏轨,还支持 4 轨分离(人声、鼓、贝斯、其他)以及最多 3 个文件的批量 ZIP 分离。
最大的亮点是隐私安全:整个分离过程都在你自己的浏览器里完成,音频文件不会上传到任何服务器。首次使用需要加载约 51MB 的模型文件,加载完成后会自动缓存,之后再用就很快了。
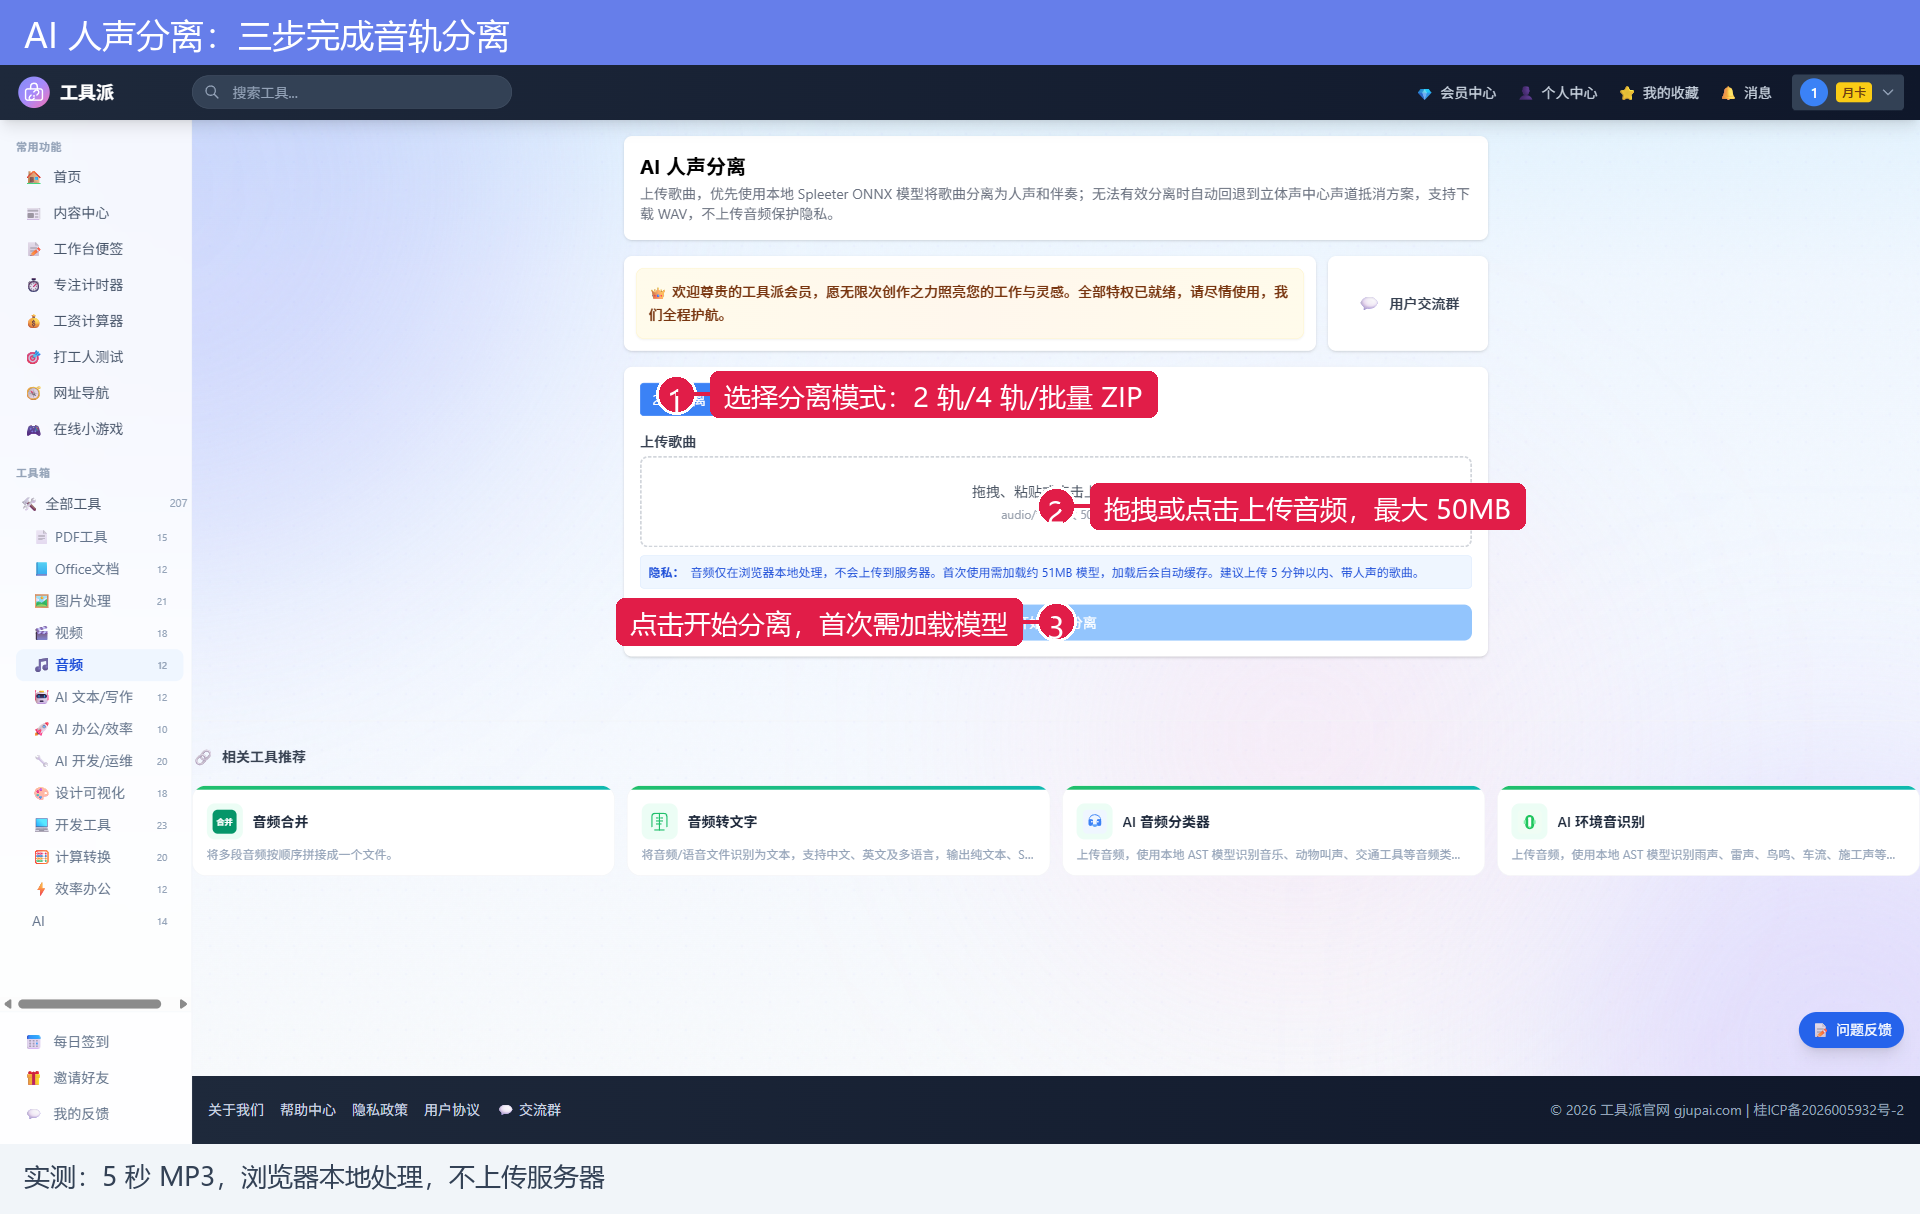
第一步:选择分离模式
工具顶部提供三种模式,按需选择:
- 2 轨分离:最常用的模式,输出人声 + 伴奏两条音轨,适合提取清唱或制作伴奏带;
- 4 轨分离:输出人声、鼓、贝斯、其他四条音轨,适合音乐制作、混音学习;
- 批量分离 ZIP:一次最多上传 3 个音频文件,分离结果打包成 ZIP 下载,适合批量处理。
模式切换是即时生效的,不需要刷新页面。
第二步:上传音频并确认
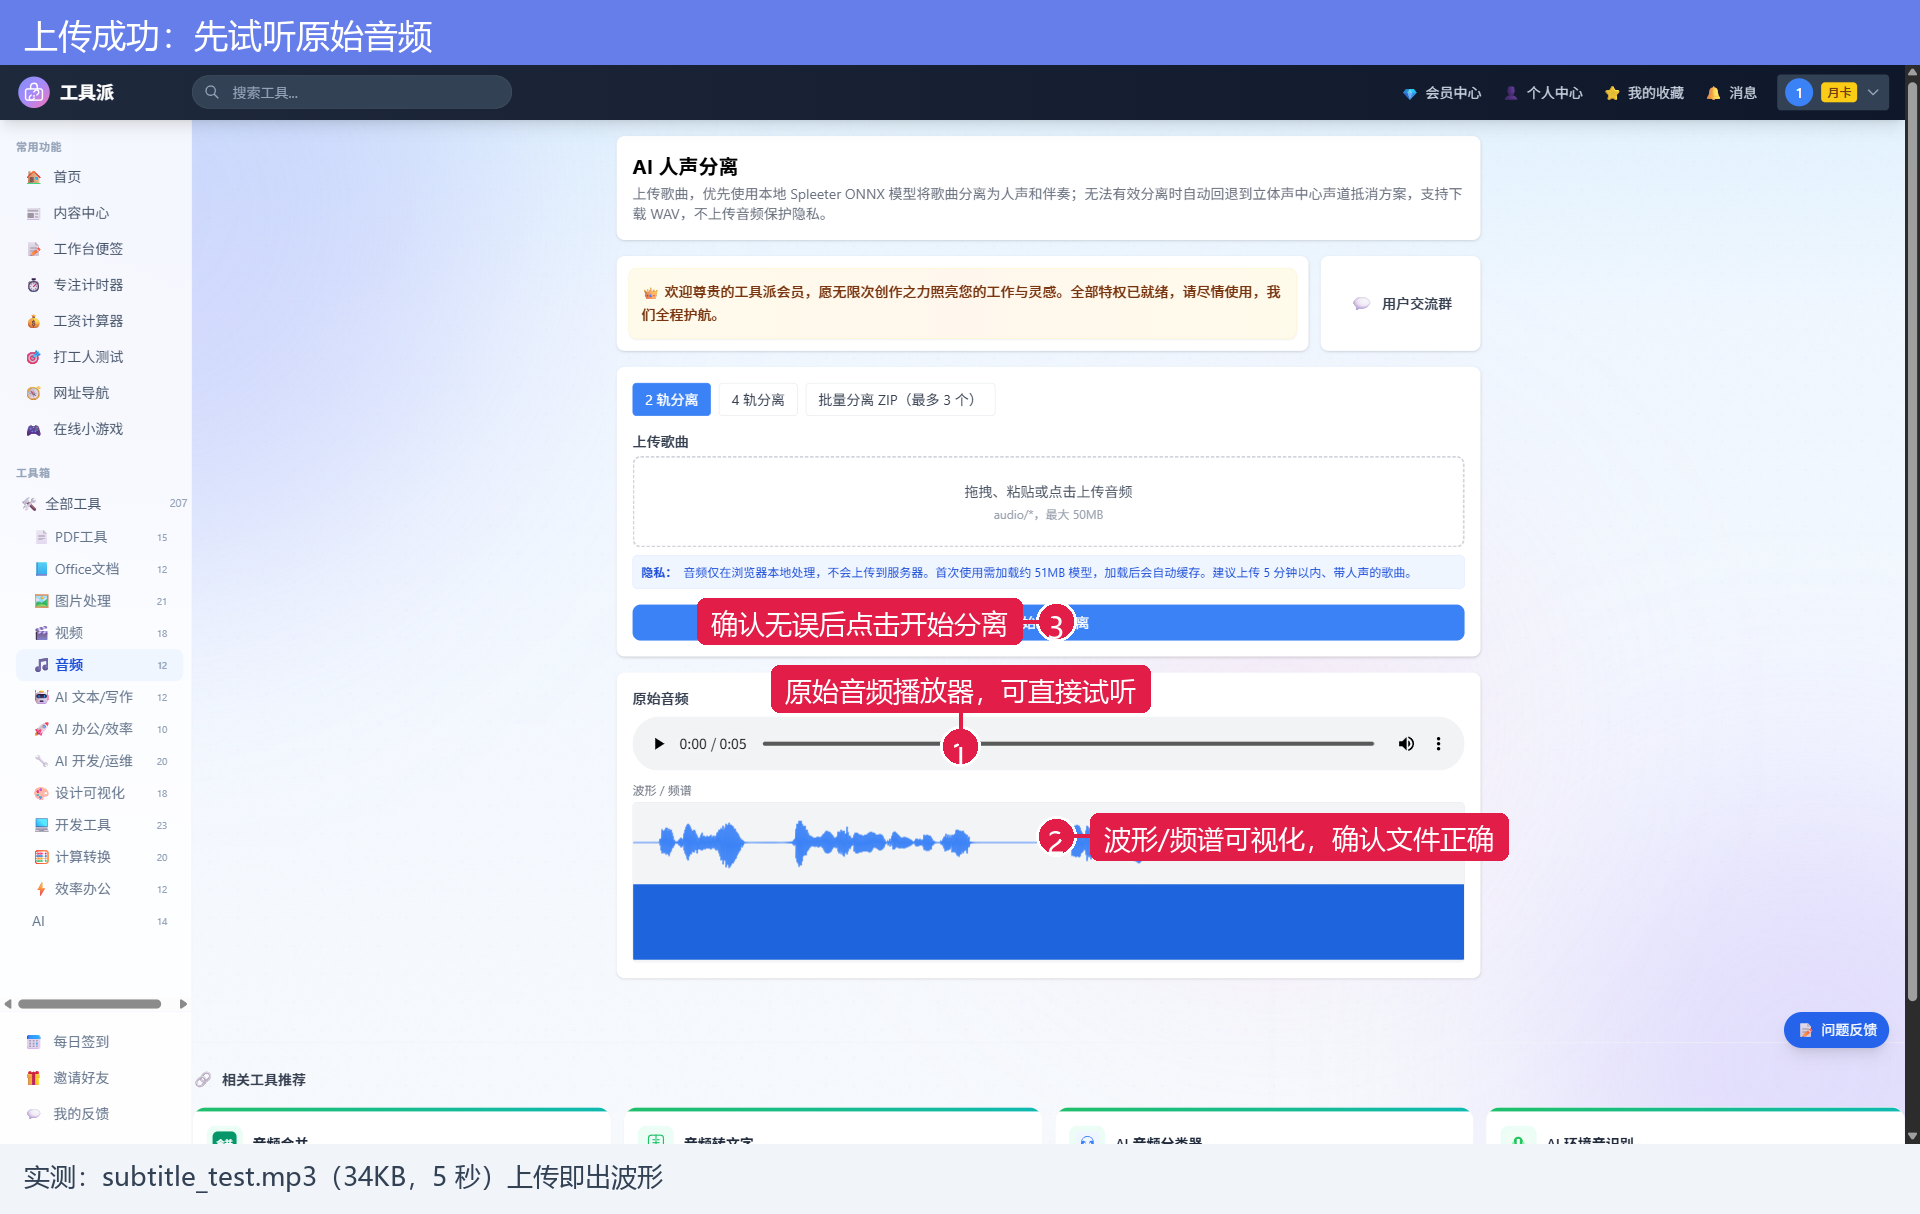
点击上传区域或直接把音频文件拖拽进去即可,支持 MP3、WAV 等常见音频格式(audio/*),单个文件最大 50MB。官方建议上传 5 分钟以内、带人声的歌曲,分离效果最好。
上传成功后页面会出现原始音频播放器和波形/频谱图,建议先试听确认文件没有传错,再点击「开始 2 轨分离」按钮。首次分离会加载模型,进度条会显示百分比,耐心等待即可;实测加载完成后 5 秒的测试音频几十秒内就分离完成。
参数说明
| 参数 | 类型 | 可选值 | 说明 |
|---|---|---|---|
| 分离模式 | 单选 | 2 轨分离 / 4 轨分离 / 批量分离 ZIP | 决定输出的音轨数量和下载形式 |
| 上传歌曲 | 文件选择器 | audio/*,最大 50MB | 支持拖拽、粘贴或点击上传,建议 5 分钟以内带人声的歌曲 |
| 批量文件数 | 限制 | 最多 3 个 | 仅批量模式,结果打包为 ZIP |
| 音量 | 滑块 | 0-100% | 结果页每条音轨可独立调节试听音量,不影响导出文件 |
| 下载格式 | 按钮 | WAV / MP3 | 人声、伴奏、混音均支持两种格式 |
第三步:试听并下载分离结果
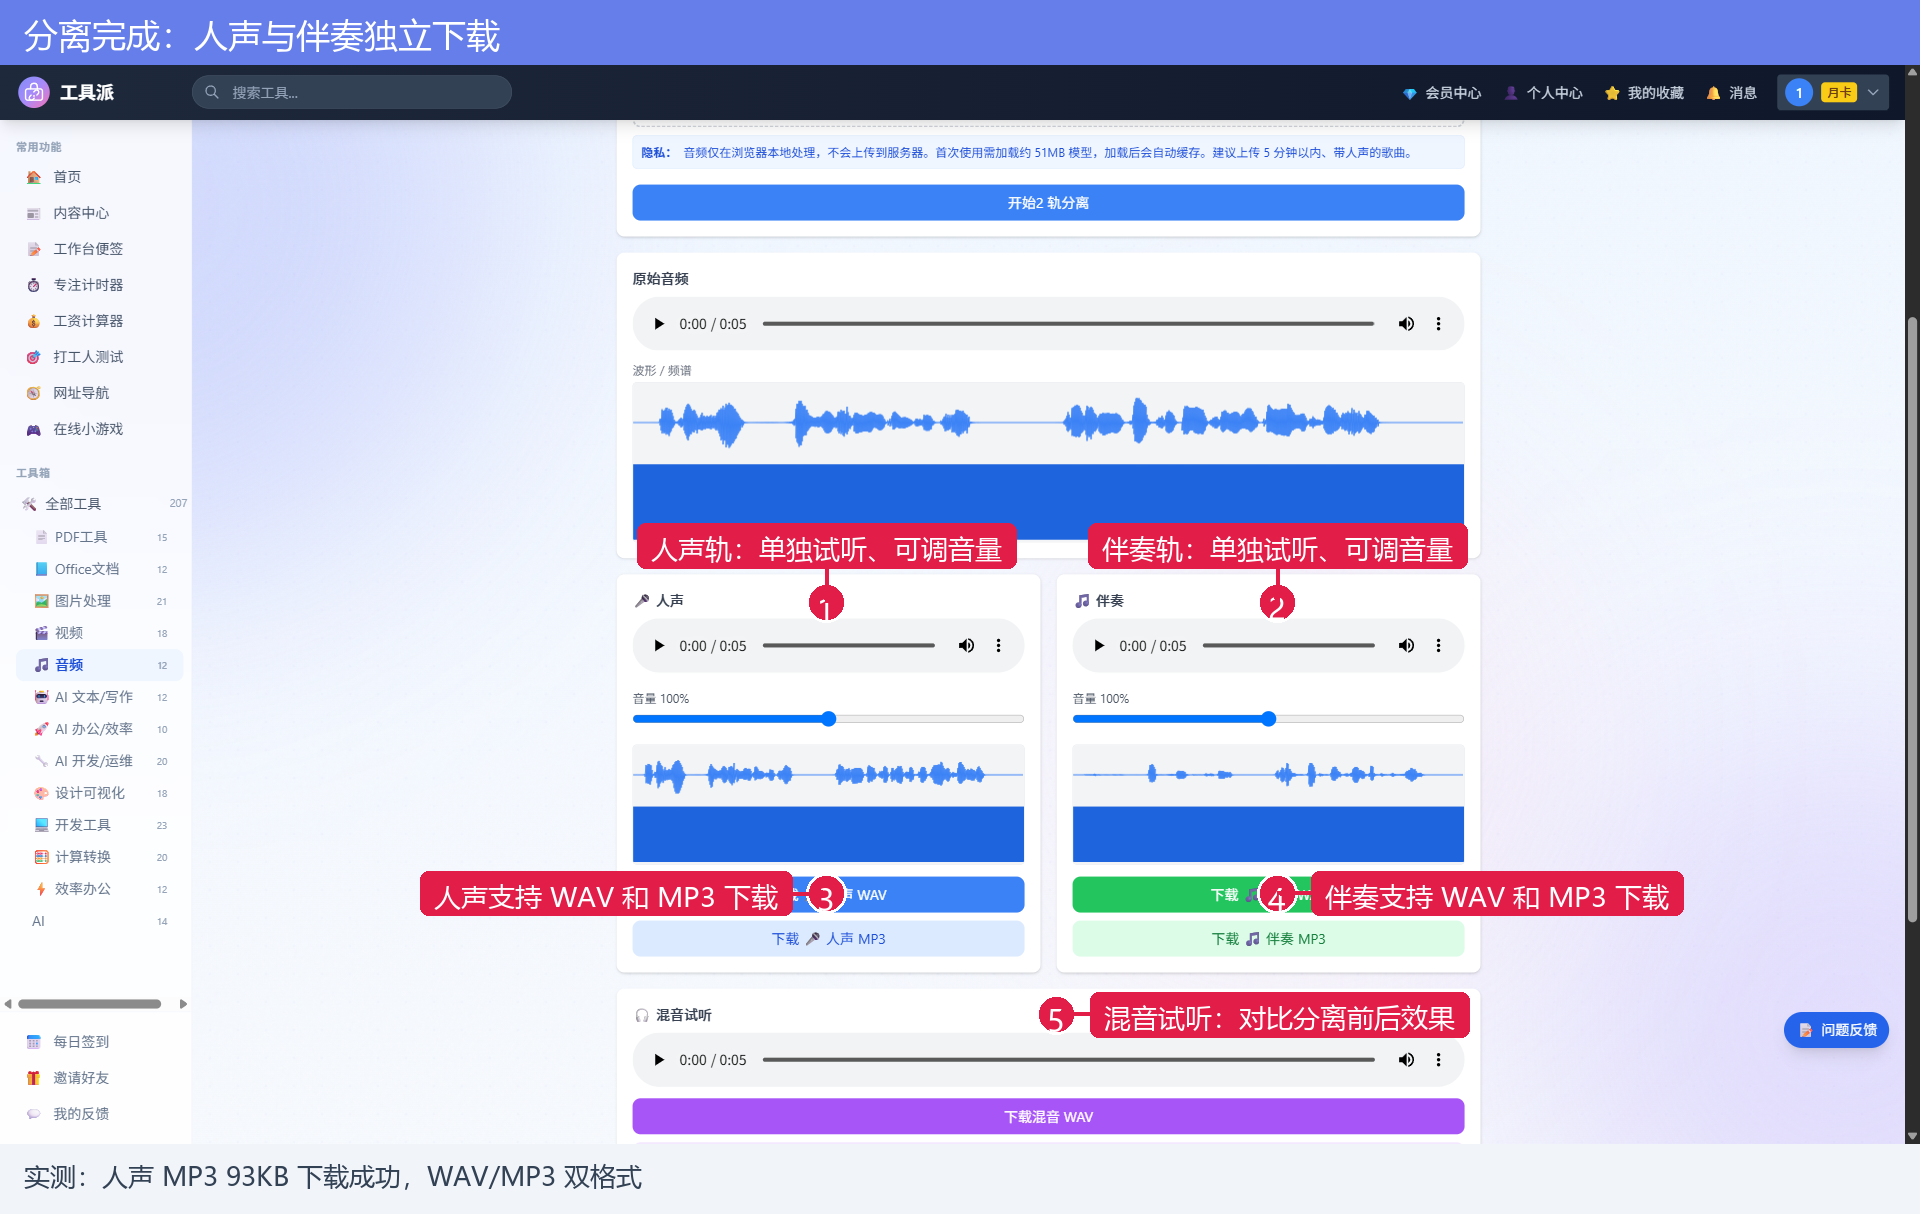
分离完成后,页面会并排展示人声轨和伴奏轨,每条音轨都有独立的播放器和音量滑块,可以单独试听。页面底部还有「混音试听」,把人声和伴奏重新混合,方便对比分离前后的效果。
每条音轨都提供 WAV 和 MP3 两种下载格式:WAV 是无损格式,适合二次编辑;MP3 体积小,适合直接分享。实测下载的人声 MP3 文件可以正常播放,人声提取干净,伴奏中只剩背景音乐。
小技巧:如果模型分离效果不理想,工具会自动回退到立体声中心声道抵消方案,保证一定有结果输出。
常见问题
1. 音频会上传到服务器吗?
不会。整个分离过程都在浏览器本地完成,音频文件不会离开你的电脑,可以放心处理未发布的原创作品或涉密录音。
2. 为什么第一次分离特别慢?
首次使用需要下载并加载约 51MB 的 Spleeter 模型,加载进度会显示百分比。模型加载后会缓存在浏览器里,之后再分离就很快了。
3. 分离出来的人声有杂音怎么办?
人声分离的效果与歌曲本身有关:人声清晰、伴奏不复杂的歌曲效果最好。建议选择 5 分钟以内、人声突出的音频;4 轨模式可以进一步把鼓和贝斯拆出来,减少伴奏残留。
4. 支持批量处理吗?
支持。切换到「批量分离 ZIP」模式,一次最多上传 3 个音频文件,分离结果会打包成一个 ZIP 文件下载,每个音频对应独立的输出。
总结与相关工具
AI 人声分离把专业的音轨分离能力搬到了浏览器里:本地处理保护隐私、2 轨/4 轨/批量三种模式覆盖大部分场景、WAV/MP3 双格式导出。无论是做卡拉 OK 伴奏、提取清唱素材,还是音乐学习,都能免费快速搞定。
立即体验:AI 人声分离
相关工具推荐:分离出的人声可以用 音频转文字 生成文稿;多段音频可以用 音频合并 拼接;不确定音频内容可以先用 AI 音频分类器 识别类别。