
工具简介
AI SQL 生成器是工具派推出的一款自然语言转 SQL 的在线工具:只要用中文(或英文)描述你想查什么——例如「查询最近 7 天创建的订单,返回订单号、金额和状态」——点击「生成 SQL」,工具就会调用云端 AI 大模型(并内置规则引擎兜底)把它翻译成可执行的 SQL 语句,同时给出一段中文解释说明。它支持 MySQL、PostgreSQL、SQLite、SQL Server、Oracle、ClickHouse 六种数据库方言,会按所选方言自动处理标识符转义和日期函数写法。你还可以粘贴 CREATE TABLE 建表语句(DDL),让 AI 按真实表结构生成更准确的 SQL。需求描述和 DDL 将上传至服务器由云端 AI 大模型处理,不会用于模型训练,生成的 SQL 可一键复制,或下载为 .sql 文件和 Markdown 文档。
功能亮点
- 自然语言转 SQL:用一句话描述查询需求即可生成完整 SQL,无需手写
SELECT/WHERE/GROUP BY语法。 - 支持 6 种数据库方言:MySQL、PostgreSQL、SQLite、SQL Server、Oracle、ClickHouse,自动按方言转义表名字段名(如 MySQL 用反引号、SQL Server 用方括号),并生成对应的日期过滤函数。
- 可粘贴表结构 DDL:填入
CREATE TABLE语句后,工具会解析出表名和字段列表,生成的 SQL 直接使用你的真实字段,准确率明显提升。 - 规则引擎 + AI 模型双保险:常见统计类需求(计数、求和、平均、最大最小、分组、最近 N 天、升降序等)先由内置规则引擎秒级生成,兜底再调用云端 AI 大模型。
- 示例与文件上传:内置「最近 7 天订单」「用户消费总额」两个示例一键填充;也支持上传
.txt/.md/.json/.csv/.log/.sql文件,.sql自动填入 DDL 框,其余填入需求框。 - 结果带格式化与中文解释:生成的 SQL 经过格式化、深色背景高亮显示,下方附黄色「解释说明」卡片,告诉你这条 SQL 做了什么。
- 三种导出 + 本地历史:可「复制 SQL」、下载
.sql文件或下载 Markdown;每次生成自动存入浏览器本地历史,可随时恢复、删除或清空。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 查询需求 | 用自然语言描述想查询的内容,必填,不填点生成会提示「请输入查询需求」 | 默认空;上传文本文件时截取前 500 字符 |
| 数据库类型 | 生成 SQL 的目标数据库方言,影响标识符转义和日期函数写法 | 默认 MySQL;可选 PostgreSQL、SQLite、SQL Server、Oracle、ClickHouse |
| 表结构 DDL(可选) | 粘贴 CREATE TABLE 建表语句,帮助 AI 按真实表名和字段生成 SQL |
默认空;上传 .sql 文件时截取前 5000 字符 |
| 上传文件 | 需求框右侧「上传文件」入口,快速导入需求或 DDL | 支持 .txt、.md、.json、.csv、.log、.sql |
| 示例 | 一键填充需求与 DDL 的内置示例 | 「最近 7 天订单」「用户消费总额」两个 |
| 生成 SQL | 提交生成按钮,生成中禁用并显示进度条 | 无需下载模型,云端处理一般 10~60 秒返回结果 |
使用步骤
- 打开工具页面:页面顶部是工具标题与简介,下方依次是蓝色提示条(说明内容由云端 AI 大模型生成、文本将上传至服务器处理)、「查询需求」输入框、「数据库类型」下拉、「表结构 DDL(可选)」输入框、示例按钮和蓝色的「生成 SQL」按钮,无需安装任何软件。
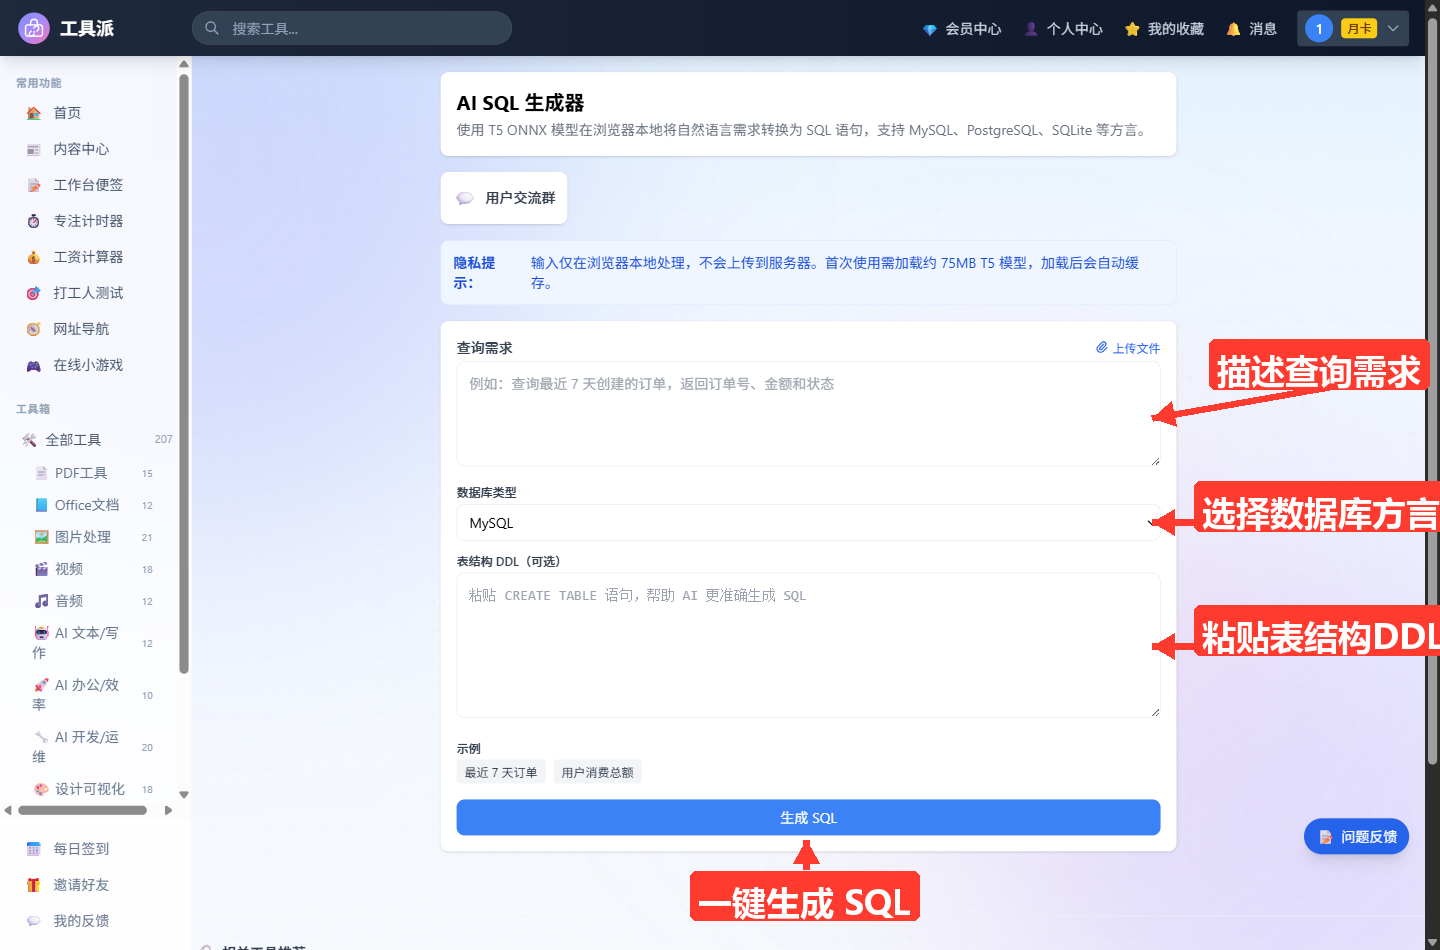
填写查询需求:在「查询需求」框中用一句话描述你想查的数据,例如「统计每个用户的消费总额,按金额降序排列」。描述里带上统计方式、时间范围、排序要求等关键词,生成结果会更准。也可以点右上角「上传文件」直接导入文本。
选择数据库类型:在「数据库类型」下拉中选择目标数据库,默认是 MySQL。不同方言生成的 SQL 在标识符引号和日期函数上会有差异(如 MySQL 的
DATE_SUB与 PostgreSQL 的INTERVAL写法),按实际环境选择即可。粘贴表结构 DDL(推荐):把相关表的
CREATE TABLE语句粘进「表结构 DDL」框,工具会解析出表名与字段,生成的 SQL 就会使用你的真实字段名;不填也可以生成,但只能按需求中的关键词推断一张默认表。点击「生成 SQL」:常见统计类需求由规则引擎即时返回;需要云端 AI 大模型时会出现进度条,无需下载模型,云端处理一般 10~60 秒返回结果。
查看并导出结果:生成后页面下方出现「生成的 SQL」卡片:深色代码块中是格式化后的 SQL,黄色卡片是中文解释说明。确认无误后可点「复制 SQL」直接粘贴使用,或点「下载 .sql」「MD」保存为文件;该次生成同时会记入页面底部的「历史记录」,之后可一键恢复。
使用技巧
- 需求里带上「动作词」:「统计/总数/多少」会生成
COUNT(*),「总金额/总和」生成SUM,「平均/均值」生成AVG,「最大/最小」生成MAX/MIN,措辞越接近这些关键词,规则引擎命中率越高、生成越快。 - 时间和排序直接说出来:「最近 7 天」「昨天」「今天」会自动生成对应方言的日期过滤条件;「降序/升序」「最新」会生成
ORDER BY ... DESC/ASC;「每个/各」会触发GROUP BY分组。 - 金额条件用「金额大于 + 数字」:例如「金额大于 100 的订单」,工具会自动提取数字生成
amount > 100的过滤条件。 - 一定粘贴 DDL:没有 DDL 时工具只能猜测表名和字段(如
orders、users、t_data),粘贴真实建表语句后生成的 SQL 才基本可以直接执行。 - 换数据库前先切方言:同一句需求在 MySQL 和 SQL Server 下日期函数完全不同,切换「数据库类型」后重新点一次「生成 SQL」即可,无需改需求描述。
- 执行前务必人工审核:工具在解释说明中也会提醒——生成的 SQL 建议先在小数据量或测试库上验证,确认逻辑无误后再用于生产环境。
常见问题
Q1:第一次点「生成 SQL」为什么比较慢?
规则引擎未覆盖的需求会交给云端 AI 大模型生成,期间会显示进度条,云端处理一般 10~60 秒返回结果,无需下载任何模型;常见的统计类需求由规则引擎处理,本身就是秒级返回。
Q2:我输入的表结构和需求会上传到服务器吗?
会。工具已接入云端 AI 大模型,输入的需求和 DDL 会上传至服务器处理,平台承诺不用于模型训练;请勿输入账号密码、身份证号等高度敏感信息。
Q3:「表结构 DDL」不填可以吗?
可以生成,但不推荐。不填时工具只能根据需求里的关键词推断一张默认表(如 orders、users、t_data)和几个通用字段,生成的 SQL 往往需要手工改表名字段名;粘贴真实 CREATE TABLE 语句后准确率会高很多。
Q4:支持哪些数据库?不同数据库生成的 SQL 有区别吗?
支持 MySQL、PostgreSQL、SQLite、SQL Server、Oracle、ClickHouse 六种。区别主要体现在标识符转义(反引号、双引号、方括号)和日期函数写法上,工具会按所选方言自动处理。
Q5:上传文件有什么用?支持什么格式?
「查询需求」右侧的「上传文件」支持 .txt、.md、.json、.csv、.log、.sql 六种格式:上传 .sql 文件时内容自动填入「表结构 DDL」框(截取前 5000 字符),上传其他格式时填入「查询需求」框(截取前 500 字符),免去手抄。
Q6:历史记录存在哪里?会丢吗?
每次生成的需求、DDL、数据库类型和结果都会自动保存到浏览器本地存储,可在页面底部「历史记录」中展开查看,支持「恢复」到输入框、单条「删除」和「清空历史」。它只存在当前浏览器中,清理浏览器数据或换设备后不会保留。