
工具简介
AI 语音情绪识别是工具派推出的一款本地 AI 音频分析工具:上传一段语音(或直接在线录音),它会在浏览器本地调用 Wav2Vec2 语音情绪模型,分析说话人的情绪倾向,给出中性、开心、悲伤、愤怒、恐惧、厌恶六种情绪的置信度分布。整个过程音频文件不会上传到服务器,只在浏览器内完成推理,既保护隐私又无需安装任何软件。除了整体情绪判定,工具还支持对较长音频做逐 5 秒情绪曲线分析,直观看到一段对话中情绪的起伏变化,识别结果还能一键导出为 JSON、CSV 或 PNG 报告。
功能亮点
- 六种情绪识别:基于本地 Wav2Vec2 模型,识别中性 😐、开心 😊、悲伤 😢、愤怒 😠、恐惧 😨、厌恶 🤢 六种情绪,每种情绪附带中文说明(如「愤怒:语速急促、音量较大,表达强烈不满」)。
- 全程本地处理:音频仅在浏览器内解码、重采样和推理,不会上传到任何服务器,适合处理会议录音、私人语音等敏感素材。
- 多种取音方式:支持拖拽、粘贴或点击上传音频文件(最大 20MB),也可以直接点「录音识别」在线录制,最长可录 30 秒。
- 主情绪卡片 + 详细分布:识别完成后顶部用大色块卡片突出显示置信度最高的情绪(emoji + 名称 + 百分比 + 解读),下方用进度条列出全部六种情绪的置信度。
- 逐 5 秒情绪曲线:音频时长 ≥ 5 秒时,可按 5 秒窗口、3 秒步长滑动分析整段音频,生成带颜色图例的折线图,并自动标出置信度超过 70% 的情绪峰值时刻。
- 三种结果导出:识别结果可导出为 JSON、CSV,或生成一张带标题、主情绪和置信度条形图的 PNG 报告图片,方便归档和分享。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 音频文件 | 待分析的语音文件,支持拖拽、粘贴或点击选择 | 音频格式(audio/*),最大 20MB |
| 录音识别 | 不上传文件时可直接在线录音 | 最长 30 秒,录音数据仅在本地处理 |
| 单次识别范围 | 「开始识别」按钮分析的内容 | 音频前 10 秒(自动转为 16kHz 单声道后推理) |
| 情绪类别 | 模型输出的情绪标签数 | 固定 6 类:中性、开心、悲伤、愤怒、恐惧、厌恶 |
| 曲线窗口 / 步长 | 情绪曲线分析时的滑动窗口设置 | 窗口 5 秒、步长 3 秒,音频需 ≥ 5 秒 |
| 峰值标记阈值 | 曲线下方自动标注的情绪峰值条件 | 置信度 > 70% 的时间点 |
| 导出格式 | 识别结果的导出方式 | JSON、CSV、PNG 报告(600×400) |
使用步骤
- 打开工具页面:顶部是工具名称和简介,下方依次是「上传语音音频」区域、录音按钮和蓝色的「开始识别」按钮,无需安装任何软件。
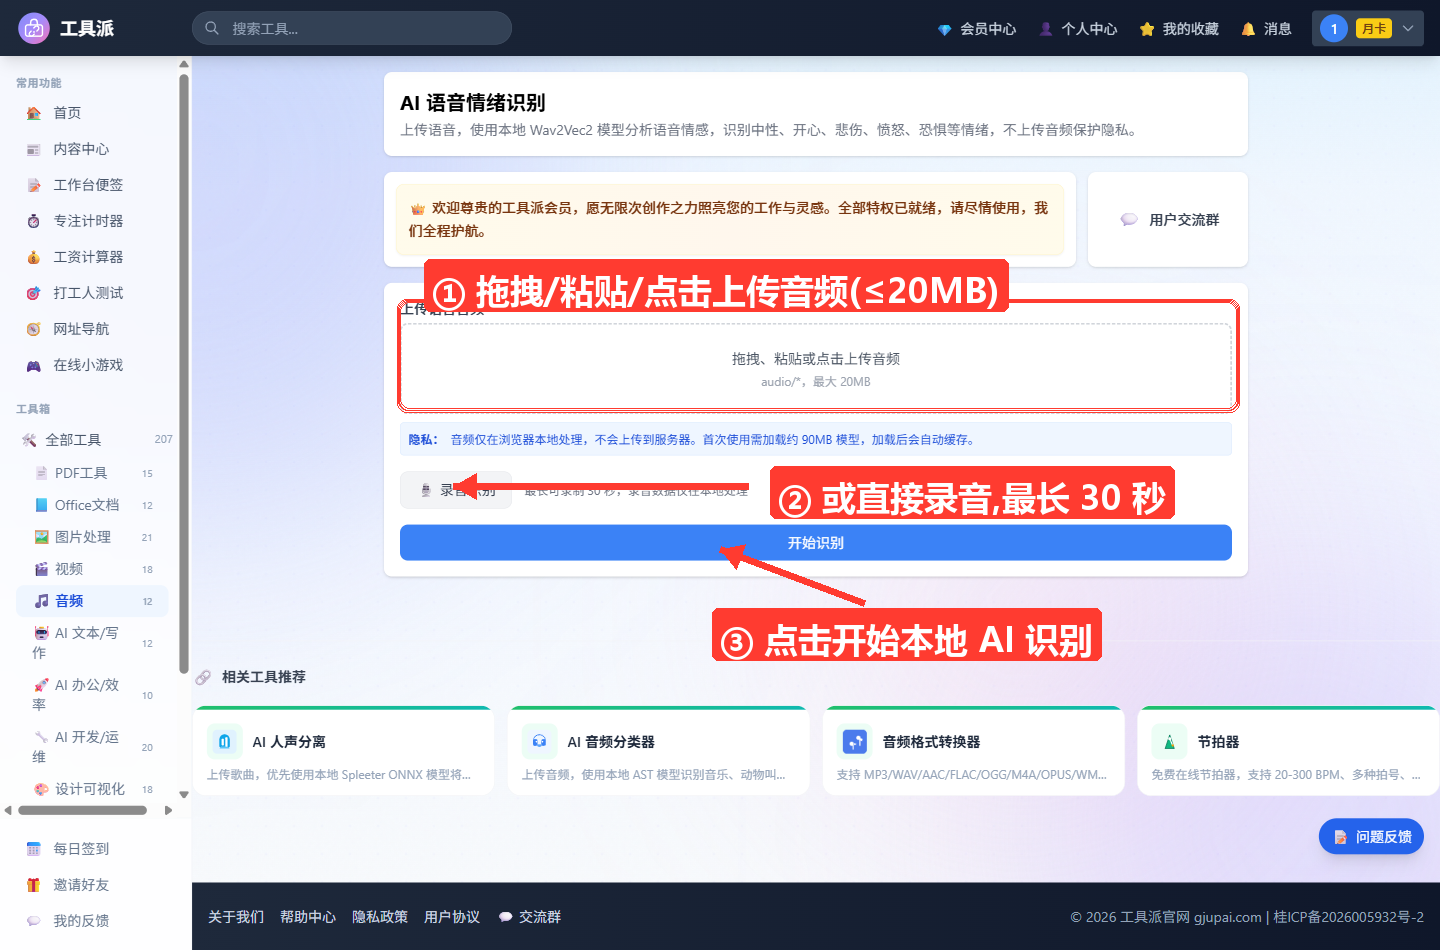
上传或录制语音:把音频文件拖进虚线框、直接粘贴,或点击选择文件(最大 20MB);也可以点「录音识别」按钮现场录制,最长 30 秒。上传成功后页面会出现一个音频播放器,可以先试听确认内容。
等待模型加载(首次使用):首次点击识别时需要加载约 90MB 的本地 AI 模型,页面会显示「AI加载中」进度条,加载完成后会自动缓存,后续使用会很快。
点击「开始识别」:工具会取音频前 10 秒进行分析。识别完成后,顶部出现主情绪卡片——大 emoji、情绪名称、置信度百分比和一句情绪解读(如「语速轻快、音调上扬,表达积极情绪」);下方「详细结果」区用进度条列出全部六种情绪的置信度。
分析情绪曲线(可选):如果音频时长超过 5 秒,页面底部会出现「逐 5 秒情绪曲线」区域,点击「分析曲线」按钮,工具按 5 秒窗口、3 秒步长逐段识别,生成折线图:横轴是时间(秒),纵轴是置信度,每个点按情绪着色,下方有图例和「峰值标记」(置信度 > 70% 的时刻)。
导出结果:在「详细结果」右侧可点「导出 JSON」「导出 CSV」保存原始数据,或点「导出 PNG 报告」生成一张含主情绪、置信度条形图和工具派署名的结果图片。
使用技巧
- 先用 10 秒以内的片段快速试:「开始识别」只分析音频前 10 秒,长录音想定位情绪高点时,应配合「分析曲线」而不是反复点「开始识别」。
- 长音频一定要看曲线:曲线按 3 秒步长滑动,比单点识别信息量大得多,能快速找到会议或访谈中情绪激动的时刻(峰值标记会直接列出时间点)。
- 录音比传文件更省事:想快速测试或分析自己刚说的一段话,直接点「录音识别」录 30 秒内即可,省去导出音频文件的步骤。
- 注意背景噪音:模型对干净的人声效果最好,背景音乐、多人同时说话会拉低主情绪置信度,正式分析前建议先降噪或截取单人发言片段。
- CSV 适合做二次统计:导出的 CSV 含「情绪」「置信度」两列,可直接用 Excel 打开做图表;需要程序处理时选 JSON。
- 首次加载慢属正常:约 90MB 模型只需下载一次并自动缓存,之后打开页面识别会快很多,建议在网络良好的环境完成首次加载。
常见问题
Q1:上传的音频会泄露吗?
不会。音频文件只在浏览器本地解码和推理,全程不经过服务器;页面也有明确的隐私提示。这也是首次使用需要加载约 90MB 模型的原因——模型下载到本地后离线运行。
Q2:支持哪些音频格式和大小?
只要是浏览器能解码的音频格式(audio/*,如 MP3、WAV、M4A、OGG 等)都可以,文件最大 20MB。工具会自动把音频转成 16kHz 单声道再送入模型。
Q3:为什么长音频的「开始识别」结果只反映开头部分?
为保证本地推理稳定,单次识别会截取音频前 10 秒。想分析整段,请使用「逐 5 秒情绪曲线」,它会按 5 秒窗口、3 秒步长覆盖整段音频。
Q4:为什么看不到「分析曲线」按钮?
情绪曲线要求音频时长至少 5 秒(一个完整窗口),短于 5 秒的音频不显示该区域;此外需要先成功上传并解码音频后才会出现。
Q5:六种情绪的置信度加起来一定是 100% 吗?
大致如此。模型输出 top 6 个标签的置信度,由于本工具固定展示全部六类,进度条可以近似理解为情绪分布,但四舍五入后总和可能略有偏差。
Q6:识别结果和实际感受不符怎么办?
情绪识别依赖语速、音调等声学特征,对反讽、压抑情绪或带背景音乐的语音可能误判。建议截取情绪最明显的片段再识别,或结合情绪曲线看多段结果综合判断。