
工具简介
AI 姿态检测是工具派推出的一款基于 MediaPipe 的在线人体姿态识别工具:上传一张人物照片,工具会在浏览器本地运行 PoseLandmarker 模型,自动检测画面中的人体并定位 33 个关键点(鼻子、眼睛、耳朵、肩膀、手肘、手腕、髋部、膝盖、脚踝等),同时在原图上绘制红色骨架连线和关键点圆点,让人体姿态一目了然。检测完成后可以下载带骨架标注的 PNG 图片,也可以导出包含每个关键点坐标的 JSON 文件,方便用于动作分析、健身姿势校正、舞蹈动作比对、AI 训练数据标注等场景。整个过程在浏览器本地完成,图片不会上传到服务器,隐私有保障。
功能亮点
- 浏览器本地运行,隐私安全:基于 MediaPipe PoseLandmarker,模型在浏览器端(WASM)加载和推理,图片全程不离开你的设备,不上传服务器。
- 33 个全身关键点:覆盖面部、躯干和四肢的标准姿态关键点,每个关键点都带有 x、y、z 三维坐标和 visibility 可见度。
- 支持多人同时检测:一张图里有多个人物时,会逐个识别并分别绘制骨架,结果区会显示检测到的人体姿态数量。
- 骨架可视化标注:自动在原图上用红色线条连接关键点、用圆点标出关节位置,姿态结构直观可读。
- 原图 / 结果左右对比:检测完成后页面并排展示「原图」和「姿态检测结果」,方便核对标注是否准确。
- 双格式导出:「下载标注图」得到带骨架的 PNG,「下载 JSON」得到结构化坐标数据,兼顾展示与二次开发。
- 打开即用,无需安装:不装任何软件、不配 Python 环境,上传图片点一下就能跑。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 上传图片 | 待检测的人物图片,点击「选择文件」从本地选择 | 支持 JPG / PNG / WEBP,最大 10MB |
| 开始检测 | 触发姿态识别;未选择图片或检测进行中时按钮不可用 | 首次检测会自动加载模型并显示进度条 |
| 检测人数 | 单张图片中可识别的人体数量 | 自动识别,单人 / 多人均可 |
| 关键点数量 | 每个检测到的人体姿态输出的关键点数 | 固定 33 个(MediaPipe Pose 标准) |
| 下载标注图 | 导出叠加红色骨架的结果图 | PNG 格式,文件名 pose_时间戳.png |
| 下载 JSON | 导出关键点坐标数据,含 poseIndex、pointCount 及每个点的 x / y / z / visibility | JSON 格式,文件名 pose_时间戳.json |
使用步骤
- 打开工具页面:页面上方是工具标题和简介,中间是「上传图片」卡片(含文件选择框和「开始检测」按钮),下方是结果展示区,无需登录即可使用。
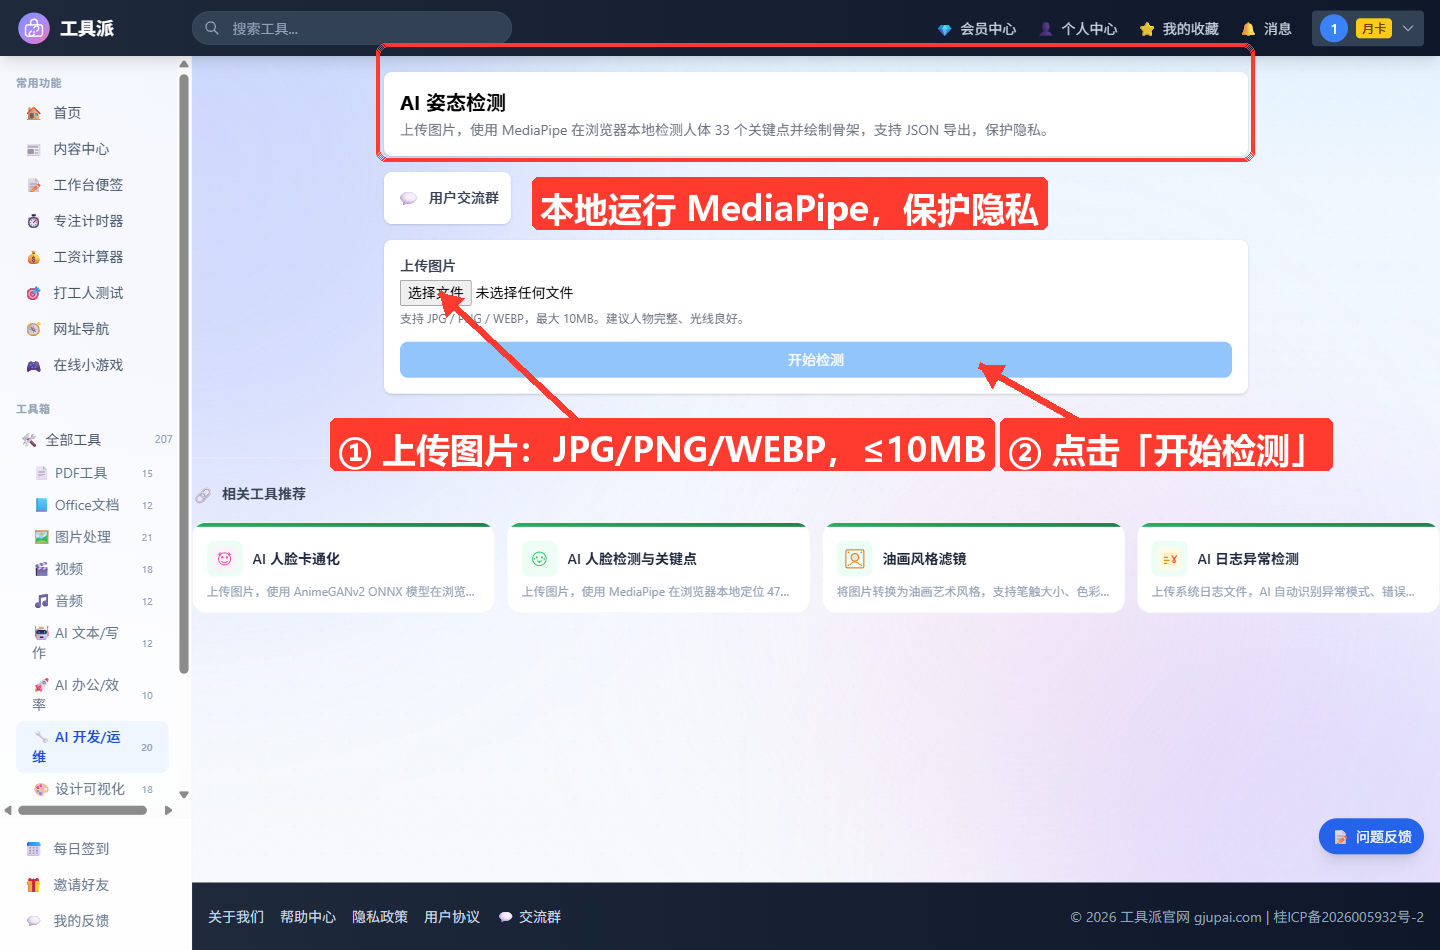
选择图片:点击「选择文件」上传一张人物照片,支持 JPG / PNG / WEBP,大小不超过 10MB。建议人物完整、光线良好,这样关键点定位更准确。
点击「开始检测」:首次使用时会先在浏览器中加载 MediaPipe 模型,页面会显示「模型加载中 X%」的进度条,加载完成后自动开始识别;之后再检测就无需等待。
查看检测结果:检测成功后,页面并排展示「原图」和「姿态检测结果」,结果图上每个关键点标有红色圆点、关键点之间以红色线条连接成骨架;下方「检测结果」卡片会提示检测到几个人体姿态、每个姿态多少个关键点。
导出结果:需要带骨架的图片时点「下载标注图」保存 PNG;需要坐标数据做点云分析、动作比对或二次开发时点「下载 JSON」,文件中每个关键点都包含归一化的 x、y、z 坐标和 visibility 可见度。
使用技巧
- 人物完整、光线充足效果最好:关键点检测依赖清晰的人体轮廓,人物被裁切、逆光或严重遮挡时容易漏检,上传前尽量选构图完整的照片。
- 遮挡越少越准:手臂交叉、多人重叠会遮挡关节,可能导致连线位置偏移,侧面或正面舒展的姿势识别效果最稳定。
- 善用 JSON 里的 visibility:每个关键点的 visibility 表示可见度置信度,二次开发时可以过滤掉低于阈值(如 0.5)的点,避免低质量关键点干扰分析。
- x / y 是归一化坐标:JSON 中的 x、y 为 0–1 之间相对于图片宽高的比例,换算成像素坐标需分别乘以图片宽和高;z 表示相对深度,可用于粗略判断肢体前后关系。
- 多人图逐个核对:多人场景下建议对照原图检查每个人的骨架归属,拥挤场景中相邻人物的连线可能串到一起。
- 首次加载慢属正常:第一次检测需要下载并初始化模型文件,耐心等待进度条走完即可,模型会被浏览器缓存,后续使用明显变快。
常见问题
Q1:我上传的图片会被保存到服务器吗?
不会。姿态检测全程在浏览器本地通过 MediaPipe 模型完成,图片只在你的设备内存中处理,不会上传到任何服务器,处理完关闭页面即释放,隐私完全由自己掌控。
Q2:支持视频或摄像头实时检测吗?
目前页面只支持上传静态图片(JPG / PNG / WEBP),不支持视频文件和摄像头实时流。如需检测视频中的动作,可以先截取关键帧图片再逐张检测。
Q3:为什么提示「未检测到人体姿态」?
通常是图片中人物太小、被严重遮挡、光线过暗,或上传的根本不是人物照片。换一张人物完整、清晰、占画面比例较大的图片再试即可。
Q4:33 个关键点都包括哪些部位?
采用 MediaPipe Pose 的标准关键点集,覆盖鼻子、双眼、双耳、嘴部、双肩、双肘、双腕、双手、双髋、双膝、双踝、双脚等全身主要关节,足以还原完整的人体骨架姿态。
Q5:第一次点「开始检测」为什么要等很久?
首次使用需要把 MediaPipe 模型文件加载到浏览器中,页面会显示加载进度条,耗时取决于网络和设备性能。模型加载后会被缓存,之后再次检测就是秒级完成。
Q6:下载的 JSON 数据能用来做什么?
可用于动作相似度比对、健身 / 瑜伽姿势校正、舞蹈动作分析、体感交互开发、AI 训练数据标注等。每个关键点都带 x / y / z 坐标和 visibility,直接对接各类姿态分析算法。