
工具简介
AI 物体检测器是工具派推出的一款在线图像识别工具:上传一张图片,它就会用 MediaPipe EfficientDet Lite0 模型在浏览器本地自动找出图中的各类物体,并用彩色标注框圈出位置、配上中文类别名和置信度百分比。模型基于 COCO 数据集训练,可识别人、汽车、动物、电子产品、家具、餐具、食物等 80 类常见物体。整个过程不依赖服务器——图片不会上传,首次使用只需下载约 7MB 的模型文件,之后自动缓存、离线也能跑。检测完成后可以并排对比原图与标注结果,查看每个目标的坐标表格,还能一键下载标注图和 JSON 数据,非常适合做数据标注核对、图片内容盘点和 AI 效果演示。
功能亮点
- 浏览器本地运行:检测完全在本机完成,图片不会上传到服务器,隐私有保障;首次加载约 7MB 模型并自动缓存,再次使用无需重复下载。
- 80 类物体识别:基于 COCO 数据集,覆盖人、交通工具、动物、配饰、运动器材、餐具、食物、家具、电子产品、日用品等常见类别,标签自动显示为中文。
- 置信度阈值可调:滑杆范围 10%–90%,默认 30%,调高可过滤低把握的结果,调低可挖出更多候选目标,调整后标注图和列表实时刷新。
- 12 个类别分组筛选:下拉可选「全部 / 人物 / 交通工具 / 交通设施 / 动物 / 配饰 / 运动 / 餐具 / 食物 / 家具 / 电子产品 / 日用品」,只关注感兴趣的类别。
- 原图 / 结果并排对比:检测结果在原图上绘制彩色边框和「中文名 + 置信度」标签,与原图左右并排展示,效果一目了然。
- 双格式导出:可下载带标注框的 PNG 图片,也可下载包含类别、置信度和坐标(xmin, ymin, xmax, ymax)的 JSON 文件,方便二次开发或存档。
- 低置信度提醒:当所有结果置信度都低于 50% 时自动提示模型可能不支持该物体类别(如银行卡、身份证、票据等卡片/证件类物品不在支持范围内),避免误读结果。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 上传图片 | 待检测的图片,支持拖拽、粘贴或点击选择 | image/*,大小不超过 10MB |
| 置信度阈值 | 只显示置信度不低于该值的检测结果,直接影响标注框数量和列表内容 | 默认 30%,范围 10%–90%,步长 5% |
| 类别筛选 | 按预设分组过滤检测结果,「全部」表示不过滤 | 默认「全部」,共 12 个分组可选 |
| 开始检测 | 触发检测的按钮,未上传图片或检测进行中时禁用 | — |
| 下载标注图 | 导出带彩色标注框和标签的 PNG 图片(detected_时间戳.png) |
检测出结果后可用 |
| 下载 JSON | 导出检测明细 JSON(detections_时间戳.json),含英文名、中文名、置信度和边界框坐标 |
检测出结果后可用 |
使用步骤
- 打开工具页面:顶部是工具名称和说明,中间上传卡片包含上传区、置信度阈值滑杆、类别筛选下拉和「开始检测」按钮,无需登录即可体验。
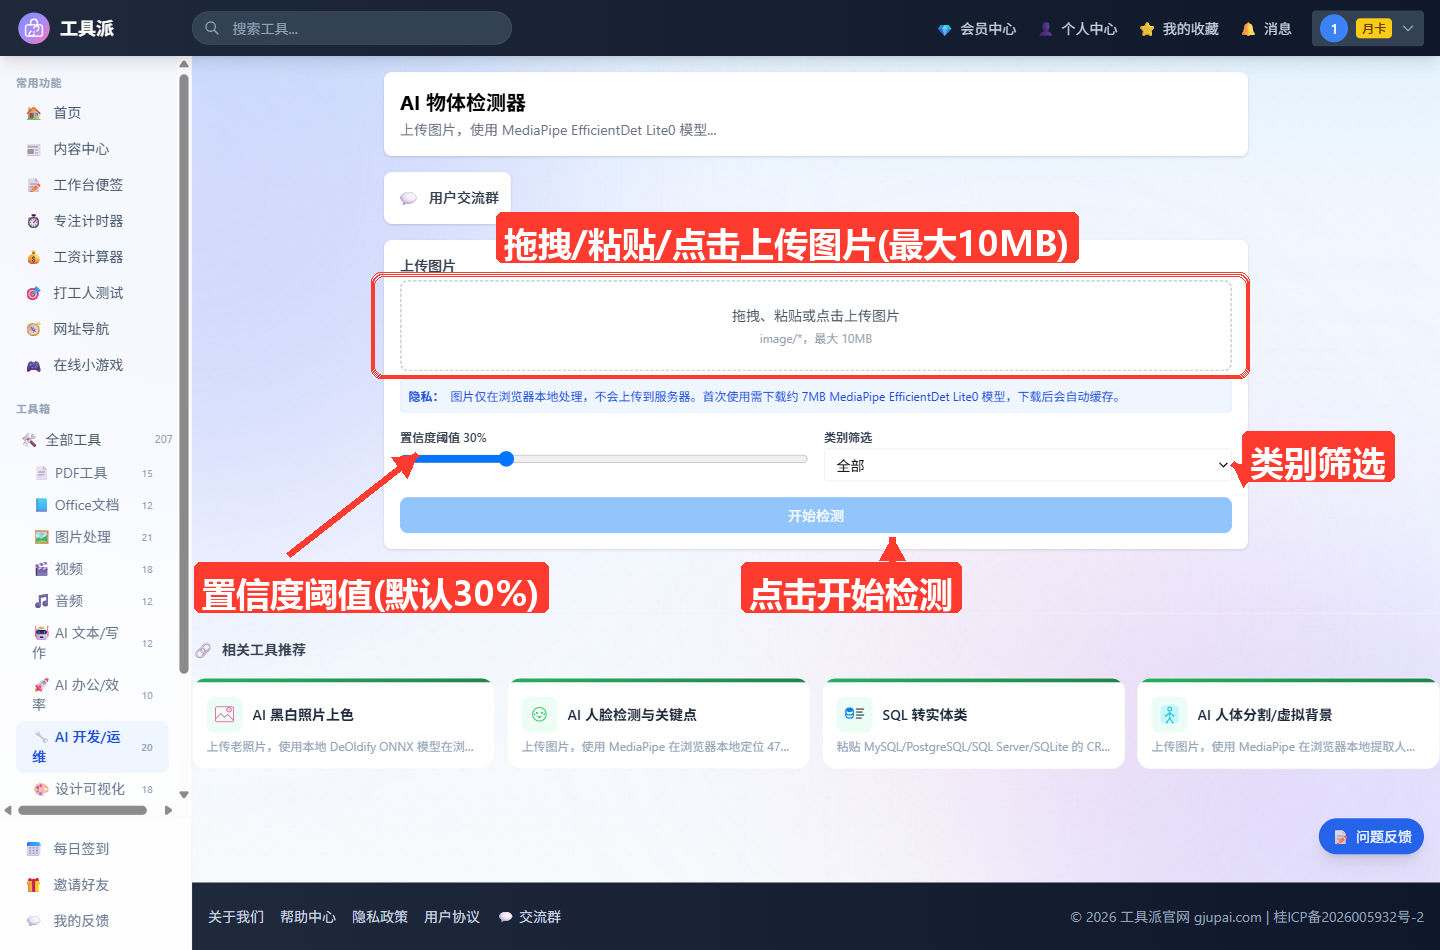
上传图片:把图片直接拖到上传区,或复制图片后在页面粘贴,也可以点击上传区选择文件;支持常见图片格式,最大 10MB。上传成功后会自动显示原图预览。
(可选)调节参数:拖动「置信度阈值」滑杆设定过滤门槛(默认 30%),并在「类别筛选」下拉中选择关心的分组——例如只想找图里的动物就选「动物」,想看全部结果保持「全部」即可。
开始检测:点击「开始检测」按钮。首次使用会先下载并加载模型(页面显示「模型加载中」进度条),加载完成后自动执行检测,按钮显示「检测中...」。
查看结果:检测完成后,右侧(移动端为下方)出现「检测结果」图,每个物体被彩色框圈出并标注「中文名 置信度%」;下方结果区以彩色标签和表格列出全部目标,表格包含类别、置信度和位置坐标四元组。此时再调阈值或类别,标注图和列表会即时重绘,无需重新检测。
导出结果:点击「下载标注图」保存带标注框的 PNG,或点击「下载 JSON」保存结构化数据,供后续程序处理或留档。
使用技巧
- 阈值先低后高:如果感觉漏检,先把阈值降到 10%–20% 看模型「疑似」检测到了什么,再逐步调高到可接受的把握度,比一味调高更容易找到平衡点。
- 用类别筛选做定向盘点:比如清点一张桌面照片里的电子产品,直接选「电子产品」分组,标注图和 JSON 都会只保留相关目标,导出的数据也更干净。
- 调参无需重新检测:阈值和类别筛选是对已有结果的实时过滤,拖动滑杆后标注图立即重绘,可以放心反复试,不会重复消耗时间。
- JSON 适合二次开发:导出的 JSON 带有像素级边界框坐标(xmin, ymin, xmax, ymax),可以直接对接裁剪、统计或入库脚本,做批量图片预处理很方便。
- 注意模型的能力边界:模型基于 COCO 数据集训练,擅长人、车、动物、家居等 80 类常见物体;银行卡、身份证、票据等卡片/证件类物品不在支持范围内,这类图片即使检测出结果置信度也会很低,页面会给出黄色提示。
- 大图细节更丰富:在 10MB 限制内尽量上传清晰、分辨率高的原图,小物体在高清图中更容易被框出来。
常见问题
Q1:上传的图片会被保存到服务器吗?
不会。图片只在浏览器本地用 MediaPipe 模型处理,全程不经过服务器;首次使用仅会下载约 7MB 的模型文件,下载后自动缓存。
Q2:支持识别哪些物体?
基于 COCO 数据集的 80 类常见物体,包括人、自行车、汽车、猫、狗、杯子、椅子、电视、笔记本、手机、书等,标签会以中文显示。银行卡、身份证、票据等卡片/证件类物品不在支持范围内。
Q3:置信度阈值调多少合适?
默认 30% 是兼顾召回和准确率的起点。追求「宁缺毋滥」可调到 50% 以上;想尽量不漏检可降到 10%–20%,再从结果中人工甄别。
Q4:检测结果里的位置坐标是什么含义?
表格中的 xmin, ymin, xmax, ymax 是标注框左上角和右下角的像素坐标,原点在图片左上角,可直接用于裁剪或绘制。
Q5:为什么检测出的结果很少或置信度很低?
可能是图中物体不属于 COCO 的 80 个类别,或物体太小、遮挡严重、图片模糊。当最高置信度低于 50% 时页面会出现黄色提示,说明模型对这张图把握不大,建议换更清晰的图片或降低阈值观察候选结果。
Q6:可以批量检测多张图片吗?
当前页面一次处理一张图片。需要批量处理时,可以逐张上传检测并下载 JSON,再用脚本合并结果;所有计算都在本地进行,多次使用不受服务器带宽限制。