
工具简介
AI 命名实体识别是工具派推出的一款智能文本分析工具:把一段中英文文本粘进输入框,云端 AI 大模型就能自动找出里面的人名、地名、组织名等命名实体,并用不同颜色高亮标注出来,同时生成一张「实体 / 类型」对照表,还能一键下载 TXT 结果。最大的亮点是无需下载任何模型、打开即用——识别由云端 AI 大模型统一完成(中英文均可),文本将上传至服务器处理,不会用于模型训练,一般 1~3 分钟内返回结果。
功能亮点
- 云端 AI 大模型识别:识别计算由云端 AI 大模型完成,无需下载模型;文本将上传至服务器处理,不会用于模型训练。
- 中英文统一识别:系统按中文字符占比自动判断语言,中文、英文及中英文混合文本统一由云端 AI 大模型识别人名、地名、机构名,无需手动切换。
- 四类实体彩色标注:识别结果分为人名(PER)、地点(LOC)、组织(ORG)、其他(MISC)四类,分别用琥珀、绿、蓝、紫四种颜色高亮,一眼区分。
- 高亮 + 表格双视图:结果区上方在原文中高亮实体并附类型小标签,下方以「实体 / 类型」两列表格列举,既能看上下文又能快速清点。
- 三个内置示例一键填充:提供「科技新闻」「旅游攻略」(中文)和「商务合作」(英文)三条样例,点一下即可填充,方便快速体验。
- 识别结果一键下载:点「下载 TXT」即可导出
ner_时间戳.txt,每行一个实体及其类型,便于导入表格或二次处理。 - 无需下载模型、进度可见:识别由云端 AI 大模型处理,一般 1~3 分钟内返回(长文本会更久),识别过程有进度提示。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 文本 | 待识别的中英文内容,在文本框中输入或粘贴 | 必填,最多 2000 字,右下实时显示「已输入/2000 字」 |
| 示例 | 一键填充到文本框的内置样例 | 科技新闻(中文)、旅游攻略(中文)、商务合作(英文) |
| 实体类型 | 被识别并高亮标注的实体类别 | 人名(PER)、地点(LOC)、组织(ORG)、其他(MISC) |
| 识别引擎 | 按文本语言自动处理,无需手动设置 | 云端 AI 大模型统一识别中英文 |
| 开始识别 | 触发识别的按钮,识别中显示「识别中...」并禁用 | 文本为空或超过 2000 字会给出错误提示 |
| 下载 TXT | 结果区右上角的导出按钮 | 导出 ner_时间戳.txt,每行格式为「实体 [类型]」 |
使用步骤
- 打开工具页面:页面自上而下依次是工具标题与简介、会员提示横幅、蓝色提示条(说明内容由云端 AI 大模型生成、文本将上传至服务器处理),以及一块白色输入卡片——内含文本输入框、示例按钮和「开始识别」按钮,无需登录即可试用,无需安装任何软件。
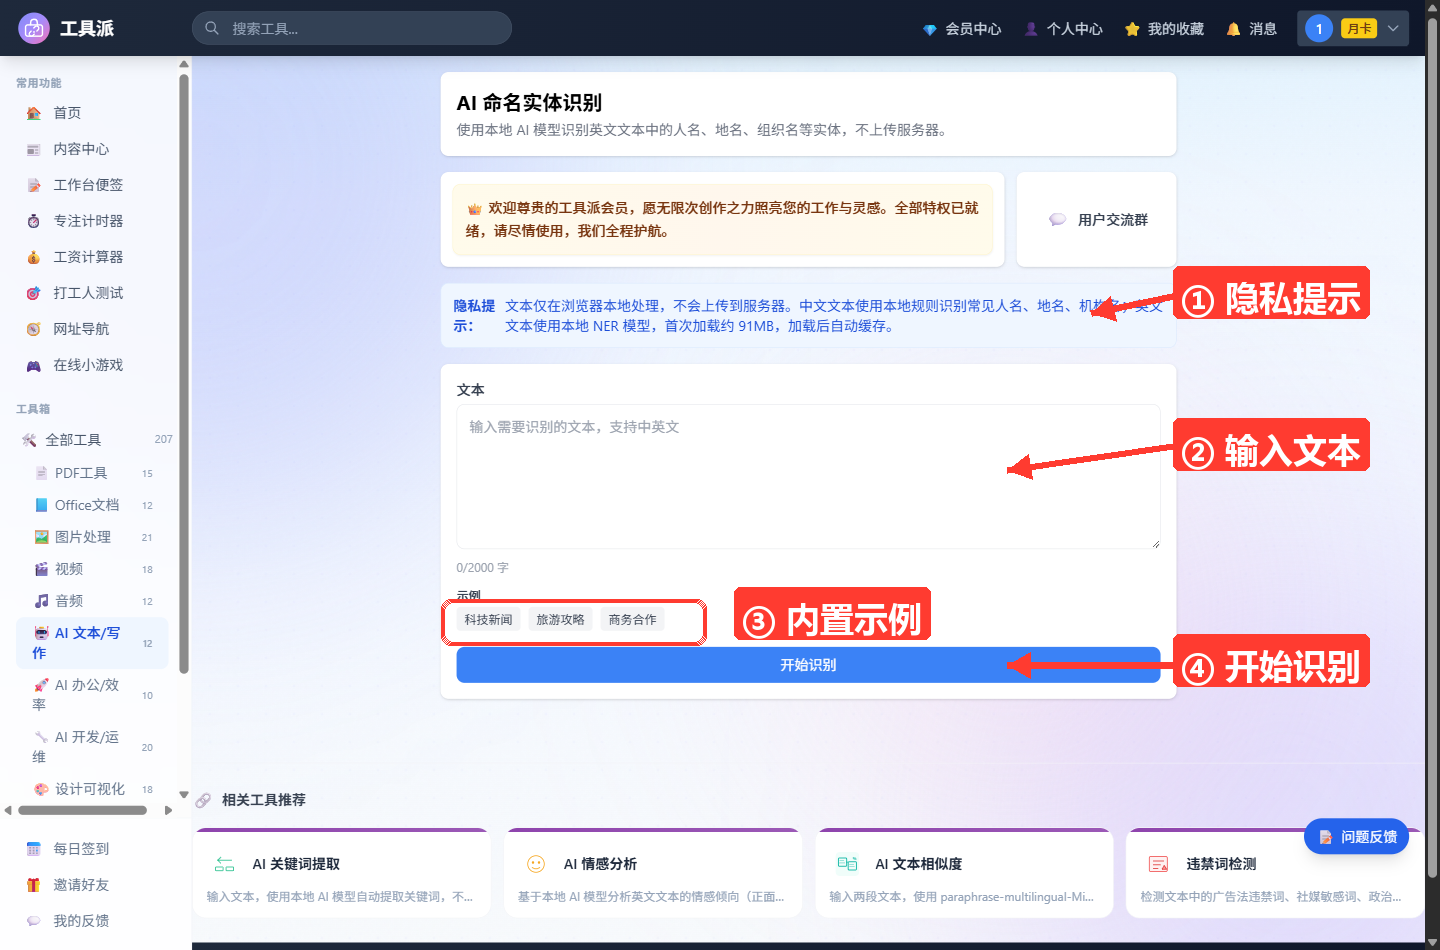
输入或粘贴文本:在「文本」输入框中粘贴或键入需要识别的内容,支持中文、英文及中英文混合,最长 2000 字,输入框右下角会实时显示当前字数。
或用示例一键填充(可选):想快速体验时,直接点「示例」下的「科技新闻」「旅游攻略」或「商务合作」,对应文本会自动填入输入框并清空上次结果。
点击「开始识别」:点击蓝色按钮开始识别。识别请求会发送至云端 AI 大模型处理,一般 1~3 分钟内返回结果(长文本会更久,请耐心等待),期间按钮显示「识别中...」并禁用。
查看识别结果:结果区上方在原文中高亮实体并标注类型(人名 / 地点 / 组织 / 其他),下方表格以「实体」「类型」两列逐一列出,方便核对与清点。
下载结果(可选):确认无误后点右上角「下载 TXT」,即可把全部实体按「实体 [类型]」逐行导出保存。
使用技巧
- 中英文会自动分流:当中文字符占全文比例超过约 30% 时按中文处理,否则按英文处理;混合文本尽量让主体语言更明确,识别更稳定。
- 给足上下文更准:云端大模型依赖上下文判断实体边界,保留完整句子、补全人名地名和机构名的完整写法,比只丢碎片词效果好。
- 耐心等待云端返回:识别由云端 AI 大模型完成,一般 1~3 分钟内返回,长文本会更久;识别中请勿重复点击按钮,以免重复提交。
- 结果为空就补充信息:如果提示「未识别到实体」,多半是文本缺少明确的人名、地名或机构线索,补全上下文或专有名词后重试即可。
- 善用下载做二次整理:导出的 TXT 每行一个实体,可直接粘贴进 Excel 或用脚本统计人名、地名出现频次,做信息抽取的初步清洗。
常见问题
Q1:我的文本会被上传到服务器吗?
会。工具已接入云端 AI 大模型,输入内容会上传至服务器处理,平台承诺不用于模型训练;请勿输入账号密码、身份证号等高度敏感信息。
Q2:识别一般需要等待多久?
识别由云端 AI 大模型完成,一般 1~3 分钟内返回,长文本会更久;请耐心等待,识别中请勿重复点击按钮。
Q3:支持识别哪些类型的实体?
支持四类:人名(PER)、地点(LOC)、组织(ORG)和其他(MISC),在结果中分别用琥珀色、绿色、蓝色、紫色高亮,并在表格中标注对应类型。
Q4:中文和英文的识别方式一样吗?
一样。中文、英文及中英文混合文本统一由云端 AI 大模型识别,工具会根据文本语言自动处理,无需手动切换。
Q5:一次最多能识别多长的文本?
单个文本框最多支持 2000 字。若超过会提示「文本长度不能超过 2000 字」,超长文档可分段识别后再合并结果。
Q6:识别不出任何实体怎么办?
通常是文本里缺少明确的人名、地名或机构线索。建议补充上下文、保留专有名词的完整写法后重试;若确实没有可识别内容,工具会提示「未识别到实体,可尝试包含更多上下文信息」。