
工具简介
AI 图像分类器是工具派推出的一款免费在线图片识别工具:上传一张图片,工具会在浏览器本地调用 ViT(Vision Transformer)图像分类模型,识别图中的主体物体属于什么类别,并给出置信度排名。它基于 ImageNet 的 1000 个类别标签,内置中英文标签映射,结果直接以中文显示。最大的特点是全程在浏览器本地运行——图片不会上传到任何服务器,隐私安全有保障;首次使用需加载约 85MB 的模型文件,加载完成后会自动缓存,之后再用就很快。除本地上传外,还支持摄像头实拍识别和 4 张内置示例图,识别结果可一键导出 JSON 或 CSV。
功能亮点
- 本地 AI 识别,隐私无忧:图片仅在浏览器本地处理,不会上传到服务器,证件照、内部资料等敏感图片也能放心识别。
- ViT 模型 + ImageNet 千类标签:采用 vit-base-patch16-224 模型,覆盖 ImageNet 1000 个常见物体类别,动物、植物、食物、车辆、日用品等都能识别。
- 中文标签显示:内置 ImageNet 中文标签对照表,识别结果直接显示「金毛犬」「披萨」这样的中文名,免去查英文标签的麻烦。
- 三种图片来源:支持拖拽 / 粘贴 / 点击上传本地图片,可调用摄像头拍照识别,还提供金毛犬、猫咪、汽车、披萨 4 张示例图一键体验。
- 四种识别模式:通用物体、动植物·动物、动植物·植物、食物,可按类别关键词过滤结果,快速聚焦你关心的类别。
- Top K 与置信度阈值可调:可选择显示 Top 3 / Top 5 / Top 10 个候选类别,并用阈值滑杆过滤低置信度结果。
- 结果一键导出:识别结果支持导出 JSON 原始数据或 CSV 表格(标签 + 置信度百分比),方便整理和二次分析。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 上传图片 | 拖拽、粘贴或点击选择本地图片 | 仅支持图片文件(image/*),最大 10MB |
| 示例图片 | 一键载入内置示例图体验识别效果 | 示例:金毛犬 / 猫咪 / 汽车 / 披萨 |
| 摄像头拍照 | 打开摄像头实时拍摄照片并识别 | 默认关闭,需授权摄像头权限,可拍照或关闭 |
| 识别模式 | 按类别关键词对识别结果进行过滤 | 通用物体(默认)/ 动植物·动物 / 动植物·植物 / 食物 |
| 显示 Top K | 模型返回置信度最高的前 K 个类别 | Top 3 / Top 5(默认)/ Top 10 |
| 置信度阈值 | 低于该置信度的标签不显示 | 0%(默认)–90%,步长 5% |
| 导出结果 | 将识别结果保存到本地 | 导出 JSON(原始数据)/ 导出 CSV(标签、置信度) |
使用步骤
- 打开工具页面:顶部显示工具名称「AI 图像分类器」和功能说明,下方依次是上传区、示例图、摄像头按钮、识别参数和「开始识别」按钮,登录用户还能看到免费额度提示。
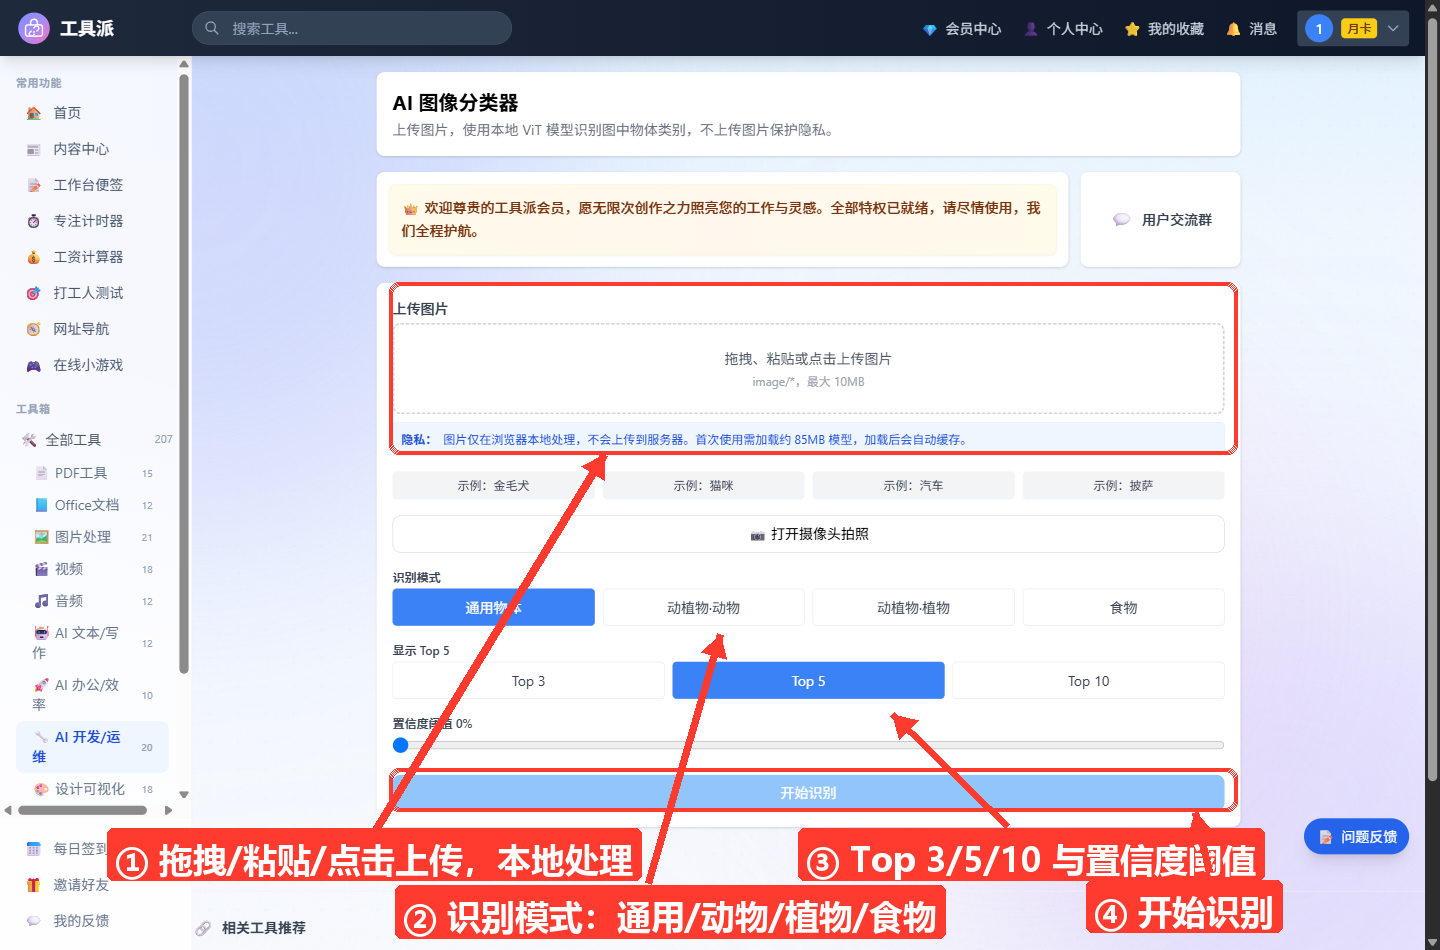
上传图片:把图片直接拖到上传框内、复制图片后在页面粘贴,或点击上传框选择本地文件,要求为图片格式且不超过 10MB;也可以点击「示例:金毛犬」等按钮载入示例图,或点「📷 打开摄像头拍照」实拍一张(授权摄像头后点「拍照」即可)。
选择识别模式:默认「通用物体」显示全部识别结果;如果你明确知道图中是动物、植物或食物,可切换到对应模式,结果会按类别关键词过滤,只保留相关标签。
设置 Top K 与置信度阈值:在「显示 Top 5」一行选择 Top 3 / Top 5 / Top 10,决定最多显示几个候选类别;拖动「置信度阈值」滑杆(0–90%)可过滤掉低置信度的噪声标签,默认 0% 表示全部显示。
点击「开始识别」:首次使用会显示「AI加载中」进度条并下载约 85MB 模型,耐心等待即可,模型会自动缓存;之后再次识别几乎是秒出结果。
查看并导出结果:下方左侧显示「原图」,右侧显示「识别结果」——每个候选类别都有中文标签、百分比置信度和进度条,最可能的类别排在最上面。确认后可点右上角「导出 JSON」或「导出 CSV」把结果保存下来。
使用技巧
- 主体清晰居中的照片识别更准:模型按 ImageNet 的物体类别训练,单主体、背景简洁的实拍照片效果最好;一张图里有多个主体时,结果通常偏向画面中最显著的物体。
- 先用 Top 5、阈值 0% 看全貌:默认设置会列出 5 个候选类别,如果第一名置信度明显领先(比如 80% 以上),基本可以确认;几个类别分数接近时说明物体模棱两可,需要人工判断。
- 调高阈值做粗筛:只想要高把握的结果时,把置信度阈值调到 30%–50%,低分噪声标签会自动隐藏,结果列表更干净。
- 识别模式是「过滤器」不是「换模型」:动物 / 植物 / 食物模式只是按关键词过滤通用模型的结果,如果切换后提示「未匹配到符合条件的标签」,切回「通用物体」即可看到全部结果。
- 善用摄像头识别实物:手机和电脑上都能调用摄像头(手机默认后置镜头),对着实物拍一张就能识别,比先拍照再找文件上传更顺手。
- 批量整理用 CSV 导出:导出 CSV 后每行是「标签 + 置信度百分比」,可以直接用 Excel 打开做记录和统计;需要程序处理则选 JSON 原始数据。
常见问题
Q1:我的图片会被上传到服务器吗?
不会。整个识别过程都在你的浏览器本地完成,ViT 模型在页面里直接运行,图片数据不会离开你的设备,可以放心识别敏感图片。
Q2:为什么第一次识别很慢,还有进度条?
首次使用需要下载约 85MB 的 AI 模型文件,下载完成后浏览器会自动缓存,之后再用就无需重复下载,识别速度会快很多。
Q3:「动植物·动物」这类识别模式是什么意思?
它们是对识别结果的类别过滤:模型本身始终是通用的 ImageNet 分类模型,切换到动物模式后,只保留标签中包含动物关键词的结果。如果过滤后为空,页面会提示你切回「通用物体」查看全部结果。
Q4:Top 3 / Top 5 / Top 10 该怎么选?
只是想确认「这张图是什么」,选 Top 3 就够了;想多给几个候选参考或做类别排查,可以选 Top 10。Top 数越大,列出的低置信度类别也越多。
Q5:置信度阈值调多少合适?
默认 0% 表示全部显示。日常查看建议保持默认;如果觉得低分标签太多干扰判断,可以调到 30% 左右,只保留模型比较有把握的类别。
Q6:为什么个别结果还是英文标签?
工具内置了 ImageNet 中文标签对照表,绝大多数类别都能显示中文;个别未收录或写法特殊的标签会回退显示英文原名,属正常现象,不影响识别准确率。