
工具简介
AI 图像描述生成是工具派推出的一款基于本地 AI 的在线图像理解工具:上传一张图片,浏览器就会自动运行图像分类模型与物体检测模型,识别画面中的主体、人物和场景元素,并自动生成一段通顺自然的中文描述文案,同时给出最多 3 个中文标签。整个过程全部在你的浏览器本地完成,图片不会上传到任何服务器,隐私有保障;生成的描述可以一键下载为 txt 文件,适合给照片写说明、为图库和素材生成 alt 文本、给电商商品图配文等场景,打开即用、无需安装任何软件。
功能亮点
- 双模型协同识别:同时使用约 85MB 的图像分类模型(ImageNet 千类标签)和约 7MB 的物体检测模型(COCO 类别),分类负责判断画面主体,检测负责找出人物和环境物体,描述更有依据。
- 自动生成通顺中文文案:不是简单罗列英文标签,而是先翻译成中文,再按「人物 / 动物 / 美食 / 交通工具 / 物品」等类型套用自然语句模板,生成完整段落。
- 置信度分级措辞:根据识别置信度自动选用「清晰地呈现」「主要展示」「可能包含」等不同措辞,描述更贴合实际把握程度。
- 人物照片专门优化:检测到人物时会点明人数(一位人物 / N 位人物),并结合穿着、佩戴配饰和周围场景元素补充细节。
- 纯浏览器本地运行:图片读取与模型推理全部在本机完成,不会上传到服务器,处理私人照片也无需担心泄露。
- 三种上传方式 + 内置示例:支持拖拽、粘贴、点击上传,还内置金毛犬、猫咪、汽车三张示例图,不找图也能立刻体验。
- 标签展示 + 一键下载:描述下方展示最多 3 个中文标签,点击「下载描述」即可保存为
caption_<时间戳>.txt文件。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 上传图片 | 待生成描述的图片,支持拖拽、粘贴或点击上传 | 仅支持图片格式(image/*),大小不超过 10MB |
| 示例图片 | 内置示例图,点击即载入,可直接生成描述 | 示例:金毛犬 / 示例:猫咪 / 示例:汽车 |
| 生成描述 | 点击后调用本地 AI 模型生成中文描述;未上传图片时按钮不可用 | 无(按钮),生成过程中显示「生成中...」 |
| 模型加载进度 | 首次使用时模型下载 / 加载的百分比进度条 | 0–100%,仅首次或缓存失效时出现 |
| 中文标签 | 从分类结果 Top-5 中翻译筛选后展示的中文标签 | 最多 3 个 |
| 下载描述 | 将生成的描述导出为 txt 文件保存到本地 | 文件名 caption_<时间戳>.txt |
使用步骤
- 打开工具页面:顶部是工具标题和简介,中部是上传卡片、示例按钮和「生成描述」按钮,无需安装任何软件,打开网页即可使用。
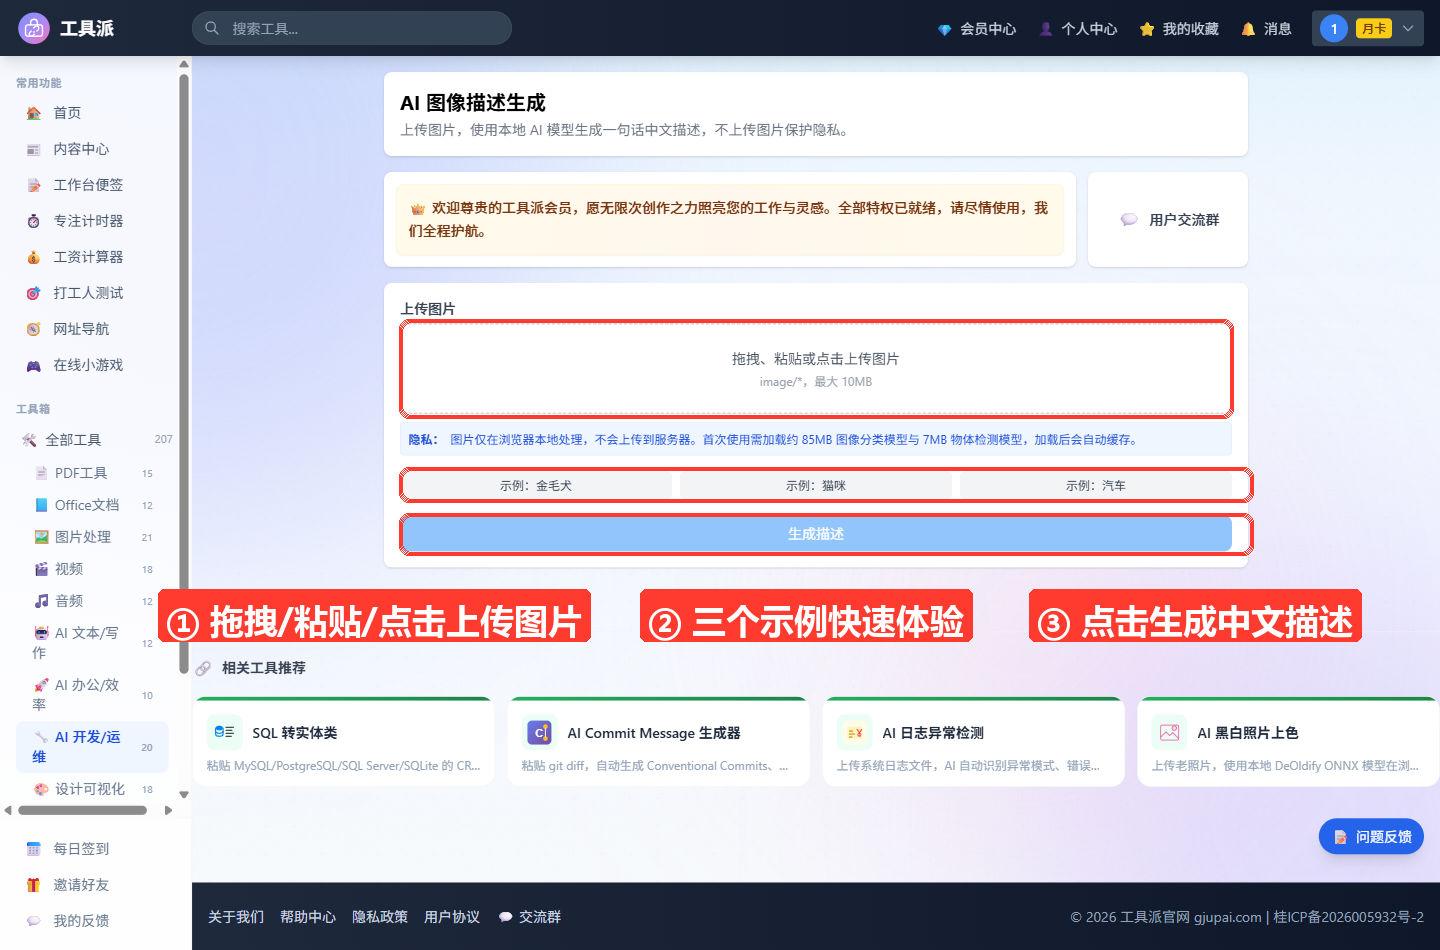
上传图片:把图片直接拖到虚线框内、在页面上粘贴剪贴板中的图片、或点击上传框选择本地文件;也可以直接点击「示例:金毛犬 / 猫咪 / 汽车」快速体验。注意仅支持图片格式,且大小不能超过 10MB,否则会提示错误。
等待模型加载(仅首次):第一次使用时页面会显示「AI 加载中」百分比进度条,需要加载约 85MB 的图像分类模型与 7MB 的物体检测模型,请耐心等待;加载完成后会自动缓存,以后再用就很快了。
点击「生成描述」:确认图片已上传后,点击蓝色「生成描述」按钮,按钮会变为「生成中...」状态,稍等片刻模型即可完成识别。
查看识别结果:处理完成后页面下方并排显示「原图」和「中文描述」两张卡片,描述卡片中是一段完整的中文文案,下方是最多 3 个蓝色中文标签。
下载描述文案:确认内容满意后,点击描述卡片下方的「下载描述」,即可把文案以 txt 文件保存到本地,用于图库说明、alt 文本或文案初稿。
使用技巧
- 首次加载慢属正常:第一次打开需要加载约 92MB 的模型文件,建议在 Wi-Fi 环境下完成首次加载;之后模型已缓存,刷新页面也能快速就绪。
- 主体突出的照片效果最好:画面主体明确、背景简洁的图片识别最稳定;纯纹理、大面积纯色或抽象图案可识别的语义信息少,描述会比较笼统。
- 人物照片让穿着更清晰:工具会根据识别到的服装、配饰标签补充「人物穿着……」等细节,人物着装清晰的照片得到的描述更丰富。
- 检测模型失败会自动降级:如果物体检测模型加载失败,工具会仅使用图像分类结果生成描述,功能依然可用,只是环境细节会少一些。
- 图片太大先压缩:超过 10MB 会被拒绝上传,过大的图片可以先用工具派的图片压缩工具处理后再上传,识别速度也更快。
- 生成文案建议人工润色:AI 描述适合做初稿和批量配图说明,正式使用前通读一遍、按实际画面微调,效果更贴切。
常见问题
Q1:上传的图片会被传到服务器吗?
不会。本工具采用浏览器本地 AI 方案,图片读取和模型推理全部在你自己的设备上完成,图片不会上传到任何服务器,页面上的隐私说明也明确标注了这一点。
Q2:为什么第一次使用时加载很慢?
首次使用需要加载约 85MB 的图像分类模型和约 7MB 的物体检测模型,页面会显示百分比进度条。加载完成后模型会自动缓存在浏览器本地,之后再用就无需重新加载,速度会快很多。
Q3:描述是怎么生成出来的?
工具先用图像分类模型取出置信度最高的 5 个标签并翻译成中文,同时用物体检测模型找出画面中的人物和物体,然后按主体类型(人物 / 动物 / 美食 / 交通工具 / 物品)套用中文语句模板,并依据置信度选择「清晰地呈现」「主要展示」「可能包含」等措辞,拼成一段通顺的描述。
Q4:支持哪些图片格式和大小?
支持浏览器可识别的常见图片格式(如 JPG、PNG、WebP 等,即 image/*),单张图片大小不能超过 10MB;上传非图片文件或超限文件时页面会给出错误提示。
Q5:为什么标签最多只有 3 个?
工具会取分类结果的前 5 个标签,翻译为中文后筛选出可识别的,展示前 3 个作为画面关键词;描述正文则可能参考更多检测结果,两者互补。
Q6:提示「无法识别图像内容」或生成失败怎么办?
如果画面过于抽象、主体不明确,模型可能无法给出有效标签,建议更换一张主体更清晰的图片;若提示「生成失败,请重试」,可刷新页面重新加载模型后再试一次。