
工具简介
AI 重复代码检测是工具派推出的一款代码质量分析工具:只要把代码打包成 ZIP 上传、直接粘贴代码文本,或填入 GitHub / GitLab 仓库地址,工具就会自动扫描其中的重复与相似代码块,给出整体重复率、文件级重复率热力图,以及每一对重复代码的并排对比和差异高亮,帮助你快速定位"复制粘贴"留下的坏味道,为重构和代码评审提供直接依据。检测前可以指定语言、调整相似度阈值和最小重复行数,还能忽略注释、空行、测试代码和生成代码,减少干扰项;检测结果支持导出 JSON、CSV、HTML 报告和 Sonar JSON 四种格式,方便存档或接入 SonarQube 等代码质量平台。
功能亮点
- 三种输入方式:支持「上传 ZIP」「粘贴代码」「仓库 URL」三种模式,整包项目、零散片段、远程仓库都能直接检测。
- 七种语言 + 自动识别:语言可选自动识别,也可手动指定 Java、Python、JavaScript、TypeScript、Go、C/C++,多语言项目用自动识别即可。
- 相似度阈值可调:阈值取值 0–1(步长 0.05),默认 0.8;调高只报几乎完全相同的代码,调低能找出结构相似但细节不同的代码块。
- 最小重复行数过滤:默认 5 行,重复块行数小于该值不会被检出,避免大量短代码片段造成的噪音。
- 忽略项多选:可勾选忽略注释、空行、测试代码、生成代码,默认已勾选注释和空行,让结果聚焦真正的业务逻辑重复。
- 文件重复率热力图:结果按文件重复率从高到低排列,每个文件用红色进度条直观展示「重复行数 / 总行数」,一眼定位重灾区。
- 逐对差异对比:每对重复代码并排展示两个文件的代码片段和行号区间,下方还有红删绿增的差异高亮,并支持一键下载四种格式的报告。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 输入方式 | 代码来源:上传 ZIP、粘贴代码或填写仓库 URL | 默认「上传 ZIP」 |
| 代码 ZIP | 把项目代码打包成 .zip 后选择上传,上传后显示文件名和大小 |
必传(ZIP 模式下) |
| 粘贴代码 | 在文本域中直接粘贴要检测的代码文本 | 必填(粘贴模式下) |
| 仓库地址 | GitHub / GitLab 仓库地址,如 https://github.com/user/repo.git |
必填(仓库模式下) |
| 语言 | 代码语言,影响解析与比对方式 | 自动识别(默认)/ Java / Python / JavaScript / TypeScript / Go / C/C++ |
| 相似度阈值 | 判定为重复/相似代码块的最低相似度,低于该值不报告 | 默认 0.8,范围 0–1,步长 0.05 |
| 最小重复行数 | 重复块行数小于该值将不会被检出 | 默认 5,最小 1 |
| 忽略项 | 检测时忽略的内容类型,可多选:注释、空行、测试代码、生成代码 | 默认勾选「注释」「空行」 |
| 输出格式 | 检测报告的下载格式 | JSON(默认)/ CSV / HTML 报告 / Sonar JSON |
使用步骤
- 打开工具页面:页面上方是工具名称和简介,下方卡片内依次是输入方式标签、代码输入区、检测参数和「开始检测」按钮,登录后可看到剩余额度。
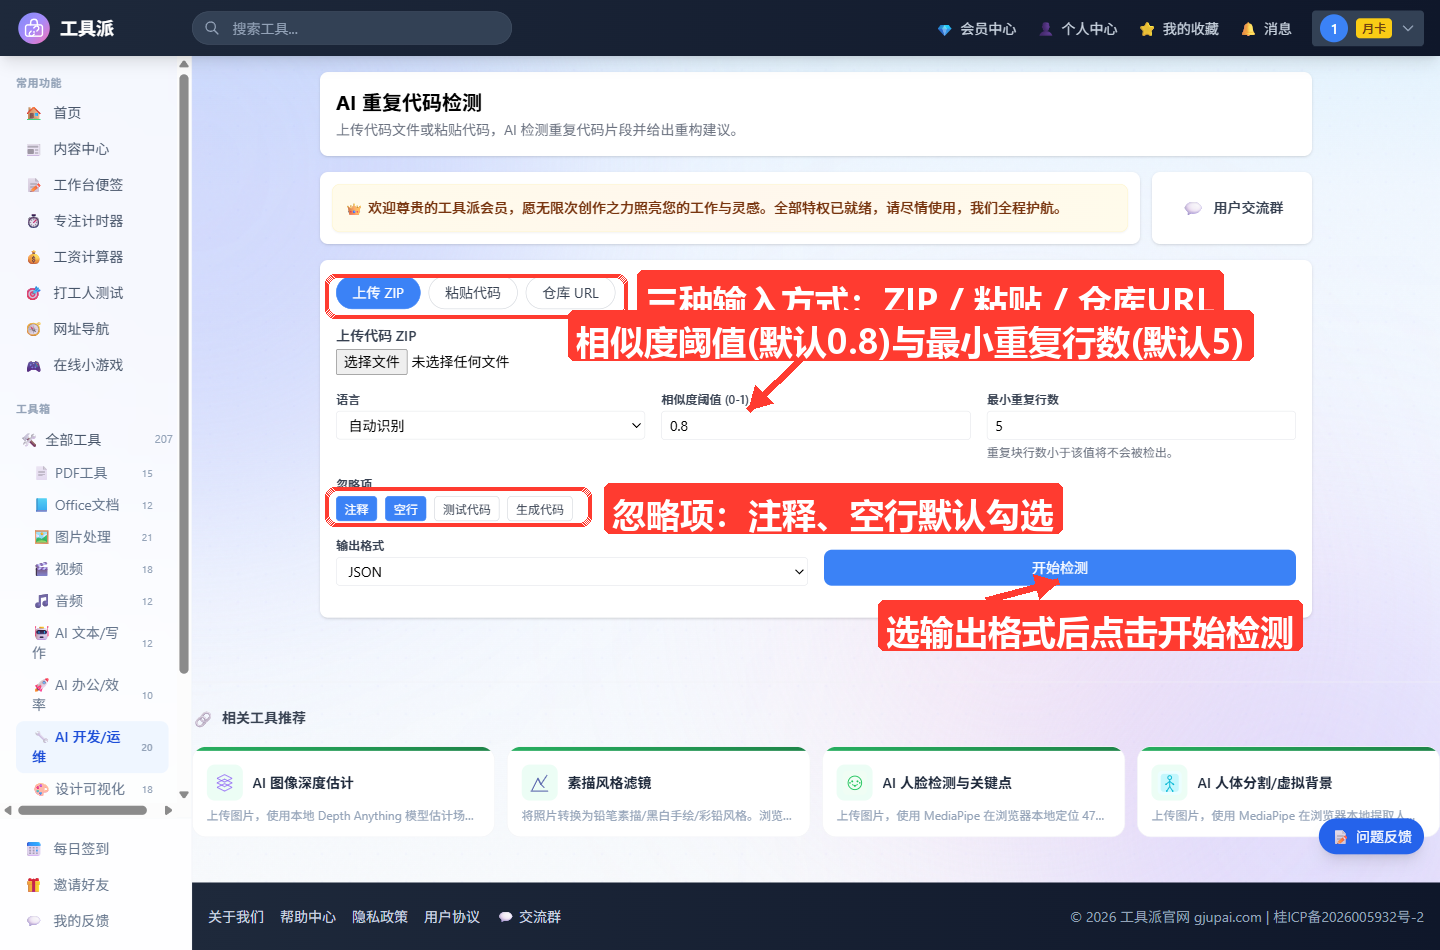
选择输入方式并提供代码:默认是「上传 ZIP」,把项目打包成 zip 后点「选择文件」上传,上传成功会显示文件名和大小;代码量少时可切到「粘贴代码」直接粘贴文本;要检测远程仓库则切到「仓库 URL」,填入形如
https://github.com/user/repo.git的地址。设置检测参数:「语言」保持自动识别即可,单一语言项目也可手动指定;「相似度阈值」默认 0.8,想抓更宽松的相似代码就调低,只想找完全复制就调高;「最小重复行数」默认 5,调小能发现更短的重复片段。
勾选忽略项:默认已忽略注释和空行;如果项目里测试目录或自动生成的代码较多,建议再勾上「测试代码」「生成代码」,让结果更干净。
选择输出格式并开始检测:在「输出格式」下拉中选择 JSON、CSV、HTML 报告或 Sonar JSON(该选项同时决定「下载」按钮导出的格式),然后点击「开始检测」,按钮会显示「检测中...」。
查看检测结果:结果区顶部四个指标卡展示重复率、文件数、重复行数、重复对数;「文件重复率热力图」按重复率降序列出各文件的红色进度条;下方逐对展示重复代码的文件名、行号区间、相似度徽章,并附带并排代码对比和红删绿增的差异高亮。若重复率为 0,页面会给出黄色提示,建议检查「最小重复行数」是否过大或适当降低阈值。
下载报告:确认结果后点击右上角「下载」按钮,按所选格式导出报告文件——JSON 适合程序化处理,CSV 适合表格评审,HTML 报告适合直接分享查看,Sonar JSON 可接入 SonarQube。
使用技巧
- 先用默认参数跑一遍再微调:阈值 0.8 + 最小 5 行 + 忽略注释空行是兼顾准确率和噪音的通用组合,先看结果量级,再决定放宽还是收紧。
- 找"改头换面"的复制就调低阈值:变量名换了、结构一样的代码相似度往往在 0.6–0.8 之间,把阈值降到 0.6 左右更容易揪出来。
- 大项目先勾掉测试和生成代码:单元测试、mock、自动生成的 model / protobuf 代码天然重复率高,不忽略的话会淹没真正的业务重复。
- 按热力图排序决定重构优先级:热力图按重复率降序排列,排在最前面、重复行数最多的文件就是重构收益最高的目标。
- 团队评审导 CSV,接流水线导 Sonar JSON:CSV 能用 Excel 直接筛选排序做评审清单;Sonar JSON 格式可对接 SonarQube,把重复代码纳入持续质量门禁。
- 未检出不等于没问题:重复率为 0 时按页面黄色提示,把「最小重复行数」调小或阈值调低再跑一次,很多短重复块是被这两个参数过滤掉的。
常见问题
Q1:三种输入方式怎么选?
整包项目检测用「上传 ZIP」,注意只支持 .zip 格式;只有几段代码想快速对比用「粘贴代码」最省事;想直接检测线上仓库就用「仓库 URL」,填入 GitHub / GitLab 仓库地址即可,无需本地下载。
Q2:相似度阈值 0.8 是什么意思?
它表示两段代码的相似度达到 80% 及以上才会被判定为重复/相似代码块并出现在结果里。阈值越高结果越严格(接近完全复制),越低则越宽松(结构相似也算),取值范围 0–1,步长 0.05。
Q3:「最小重复行数」有什么作用?
它过滤掉太短的重复片段:重复块的行数小于该值(默认 5 行)就不会被检出。短小的样板代码(如 getter/setter、import 块)很容易"撞车",设一个下限可以大幅减少无意义的噪音结果。
Q4:四种输出格式有什么区别?
JSON 是完整的结构化结果,适合二次开发处理;CSV 按「文件A、文件B、行号区间、重复行数、相似度」逐对导出,方便表格软件查看;HTML 报告是可离线打开的网页报告;Sonar JSON 则用于对接 SonarQube 等代码质量平台。
Q5:检测结果是 0 重复,但我确定代码里有复制粘贴?
先按页面上的黄色提示排查:最常见原因是「最小重复行数」设得太大把短重复块过滤了,或阈值偏高。把最小行数调到 3、阈值降到 0.7 左右再试一次,通常就能看到结果。
Q6:忽略项里的「测试代码」「生成代码」是什么?
勾选后检测会跳过测试目录/测试文件以及工具自动生成的代码(如 ORM 模型、接口桩代码)。这两类代码重复是常态而非问题,忽略它们能让报告聚焦在真正需要重构的业务代码上。