
工具简介
AI 音频分类器是工具派推出的一款本地 AI 音频识别工具:上传一段音频(或直接现场录音),工具会用 AST(Audio Spectrogram Transformer)模型在浏览器本地分析声音内容,给出「音乐、语音、狗叫声、雨声、警笛声……」等类别标签及对应的置信度,并把常见英文标签翻译成中文。整个识别过程在浏览器内完成,音频文件不会上传到服务器,隐私有保障。除单个识别外,它还支持最多 5 个文件的批量识别、六种识别模式过滤、BPM/能量/调性等音频特征分析,以及结果的一键导出,适合音频素材整理、环境音分析、音乐曲风判断等场景。
功能亮点
- 本地 AST 模型识别:基于 Transformers.js 在浏览器端加载 AST 音频分类模型,音频全程不上传服务器;首次使用需加载约 87MB 模型,之后自动缓存,再次使用无需重复下载。
- 单个 + 批量双模式:「单个识别」用于精细分析一个文件;「批量识别」一次最多处理 5 个音频,结果以表格展示每个文件的 Top1 标签、置信度和 Top5 标签。
- 六种识别模式:全部分类、音乐/乐器、语音/人声、动物声音、自然声音、音乐曲风。选择分类模式后只显示该类别的标签;「音乐曲风」模式会取 Top 25 结果并过滤出古典、流行、摇滚、爵士、嘻哈等流派标签,自动翻译为中文。
- 结果数量与阈值可调:「显示 Top」可选 3 / 5 / 10 条结果;「置信度阈值」滑杆(0%–90%)可过滤掉低置信度的噪声标签,让结果更干净。
- 现场录音识别:内置录音按钮,最长可录制 30 秒,录完直接参与识别,录音数据同样只在本地处理。
- 音频特征分析:上传后自动计算并展示 BPM(节拍)、能量(RMS)和调性(主音),配合波形可视化和内置播放器,边听边看更直观。
- 结果导出与历史记录:单个结果可导出 JSON 或 CSV;批量结果可导出汇总 CSV(含 Top1、Top5)或完整 JSON。最近 10 条识别记录保存在本地浏览器,方便回溯。
参数说明
| 参数 | 说明 | 默认值 / 取值范围 |
|---|---|---|
| 识别方式 | 「单个识别」分析一个文件,「批量识别」一次处理多个文件 | 默认「单个识别」;批量最多 5 个文件 |
| 上传音频 | 拖拽、粘贴或点击上传,支持常见音频格式 | 单个文件不超过 20MB |
| 录音识别 | 点击按钮现场录音并直接识别 | 最长 30 秒,仅单个识别模式可用 |
| 识别模式 | 过滤结果标签所属的类别 | 全部分类(默认)/ 音乐·乐器 / 语音·人声 / 动物声音 / 自然声音 / 音乐曲风 |
| 显示 Top | 识别结果展示的标签条数 | Top 3 / Top 5(默认)/ Top 10;曲风模式固定取 Top 25 再过滤 |
| 置信度阈值 | 低于该置信度的标签不显示 | 0%(默认)– 90%,步长 5% |
| 导出格式 | 单个结果导出标签+置信度;批量导出含文件名、Top1、Top5 | JSON / CSV |
使用步骤
- 打开工具页面:顶部是工具名称和简介,下方「单个识别 / 批量识别(最多 5 个)」两个标签页用于切换识别方式,无需上传服务器、保护隐私。
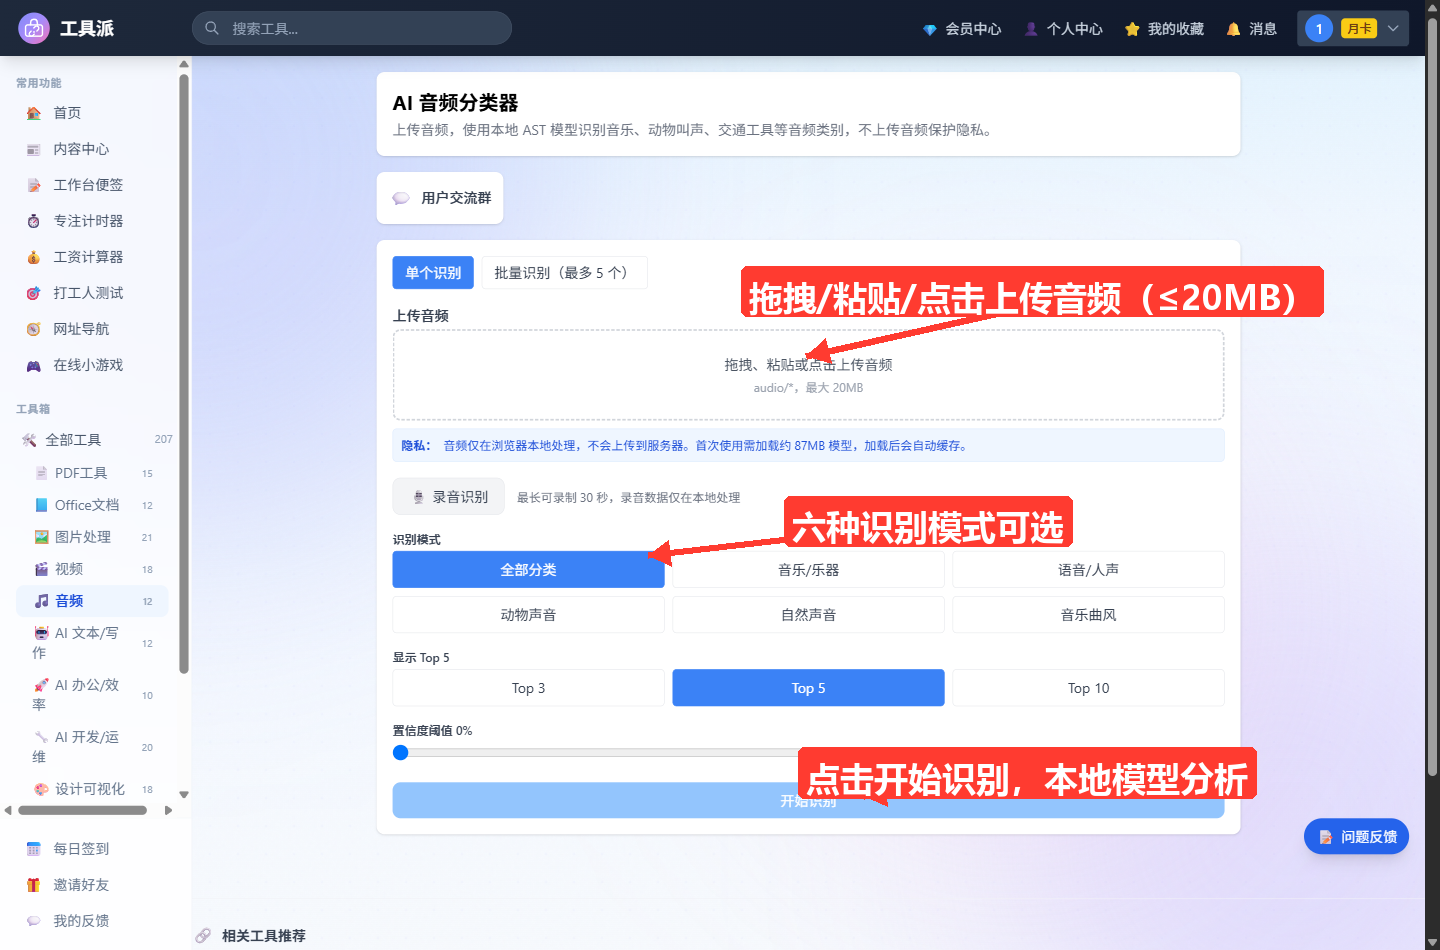
上传音频:在「单个识别」页,把音频文件拖进虚线框、直接粘贴,或点击选择文件(最大 20MB);也可以点「录音识别」现场录制最长 30 秒的声音。上传后页面会自动显示播放器、波形图,以及 BPM、能量、调性三个特征指标。
选择识别模式:在「识别模式」按钮组中选择类别——不确定内容时保持「全部分类」;只想看流派时选「音乐曲风」;分析录音素材时可按需要选「语音/人声」「动物声音」「自然声音」等,结果会按所选类别过滤。
设置结果数量与阈值:在「显示 Top」中选择展示 3、5 或 10 条标签;拖动「置信度阈值」滑杆过滤低置信度标签(例如设到 30% 可去掉大部分噪声结果)。
开始识别并查看结果:点击「开始识别」,首次使用会先加载约 87MB 的本地模型(自动缓存)。识别完成后,结果区按置信度从高到低显示标签和百分比进度条;若当前模式下没有匹配标签,可切回「全部分类」查看全部结果。
导出或批量处理(可选):单个结果可点「导出 JSON / 导出 CSV」保存;需要处理多个文件时切换到「批量识别」,一次选择最多 5 个音频,识别完成后在表格中查看每个文件的 Top1 与 Top5,并一键导出汇总 CSV 或完整 JSON。最近的识别记录会显示在页面底部的「最近识别记录」中。
使用技巧
- 第一次使用耐心等待模型加载:约 87MB 的 AST 模型只需下载一次并自动缓存,之后打开即用;网络慢时进度条停住属正常现象。
- 先用「全部分类」摸底,再用分类模式精筛:「全部分类」给出模型最原始的判断,确认音频大致内容后再切换到对应模式,可避免误过滤掉关键标签。
- 曲风判断记得切「音乐曲风」模式:该模式会取 Top 25 结果并过滤出古典、流行、摇滚、爵士、嘻哈、电子等流派标签并翻译为中文,比普通模式更容易看出曲风倾向。
- 用置信度阈值做「降噪」:环境音、混合素材常带一堆低分标签,把阈值拉到 20%–40% 只保留高置信度结果,导出 CSV 时也更清爽。
- 批量识别适合整理素材库:一次 5 个文件,导出 CSV 后表格里直接有「文件名 + Top1 标签 + Top5」,可用于给音效库批量打标签。
- 结合 BPM/能量/调性交叉验证:识别为「音乐」且 BPM 正常(60–180)、能量较高的片段可信度更高;BPM 为 0 多为语音或无规律环境音。
常见问题
Q1:音频会上传到服务器吗?
不会。模型通过 Transformers.js 在浏览器本地加载和运行,上传的文件、录音数据都只在本地处理,页面上的隐私提示也明确说明了这一点。
Q2:为什么第一次识别很慢?
首次使用需要下载约 87MB 的 AST 模型文件,下载完成后会自动缓存到浏览器,之后再次使用就很快了。如果清理了浏览器缓存,则需要重新加载。
Q3:支持哪些音频格式?文件大小有限制吗?
支持浏览器可解码的常见音频格式(如 MP3、WAV、M4A、OGG 等),单个文件不能超过 20MB,超过会提示「音频大小不能超过 20MB」;批量模式同样按此限制过滤文件。
Q4:「音乐曲风」模式和普通模式有什么区别?
普通模式只返回 Top 3/5/10 个标签;曲风模式会先取 Top 25 个结果,再从中过滤出古典、歌剧、流行、摇滚、金属、爵士、布鲁斯、嘻哈、电子、氛围等流派标签,并把英文标签翻译成中文,专门用于判断音乐风格。
Q5:识别结果是英文标签看不懂怎么办?
工具内置了常用标签的中文翻译(如 Speech→语音、Dog→狗叫声、Rain→雨声、Guitar→吉他等),常见类别会自动显示中文;少数冷门标签仍显示英文原名,属正常现象。
Q6:识别记录保存在哪里?会丢吗?
最近 10 条识别记录(文件名、Top1 标签、置信度、时间)保存在浏览器 localStorage 中,只存在当前设备当前浏览器里;清理浏览器数据或点击「清空」按钮后记录即被删除。